PoCで終わらせないAI開発|本番運用に必要なクラウドインフラの考え方
「検証用の環境では快適に動いていたのに、部署全体に公開した途端に応答が遅くなった」「公開後の監視や障害対応をどう準備すればよいのか分からない」というケースは少なくありません。
動くものができていることと、多数の利用者が毎日使い続けられることの間には、性能・安全性・復旧手段・運用体制という明確な差があります。
本記事では、
- PoCと本番運用の違い
- 本番移行に必要なクラウドインフラの基本構成
- 設計前に決めるべき要件
- 公開までの検証手順
を解説します。扱う範囲は、既存モデルやAPIを利用するAIアプリケーションの推論・提供基盤が中心です。モデルの学習基盤や大規模分散学習の設計は対象外とし、必要になる場面に限って補足します。
NVIDIA H200を搭載したGPUが、業界最安値で使える!
最先端のNVIDIA H200を、業界最安値クラスでご提供。学習・推論のスピードはそのままに、GPUコストを大幅圧縮。生成AI・LLM学習・シミュレーションなど大規模計算に最適。オンプレミスや他社クラウドと比べても圧倒的に低コストで、最新GPUを手軽に利用できます。
AI開発でPoCと本番運用は何が違うのか
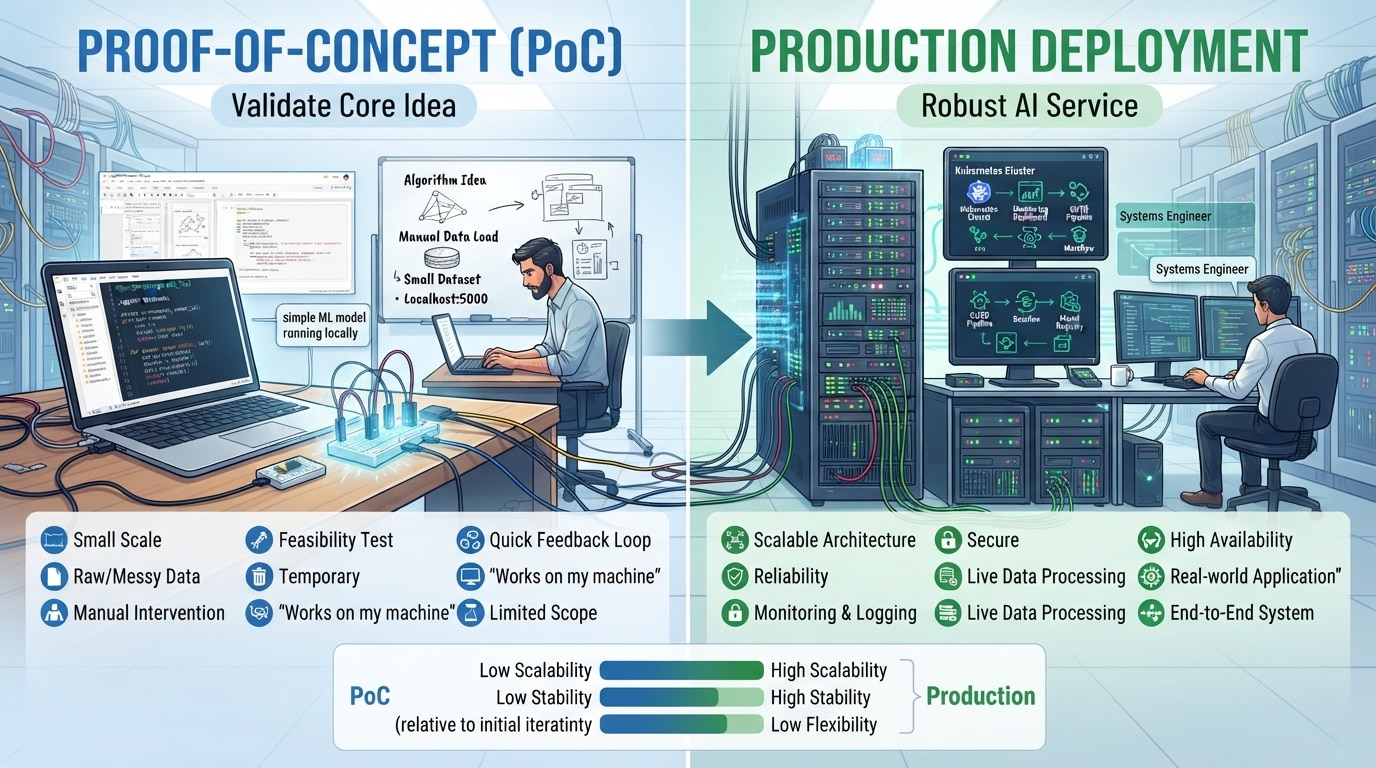
PoCの目的は、技術的・業務的な仮説を検証することにあります。
- 「社内文書をベクトル検索して生成AIに渡せば、目的の情報にたどり着けるか」
- 「その回答は業務で使える品質か」
を、限られた人数・限られたデータで確かめる工程です。したがってPoCの成功条件は、狙った仮説に対して判断材料が得られたかどうかであり、環境が多少手作業で組まれていても、担当者のノートPCで動いていても問題にはなりません。
一方で本番運用に移ると、評価軸そのものが入れ替わります。
求められるのは「動くこと」ではなく、想定した利用者が、想定した頻度で、想定した品質の応答を、継続的に得られることです。ここには、ピーク時間帯の性能、権限のないデータを見せない安全性、障害が起きたときの復旧手段、そして担当者以外でも運用できる体制までが含まれます。
重要なのは、この「継続利用の条件」がすべてのAIで同じではない点にあります。
継続利用の条件を満たす必要がある
PoCと本番で何が変わるのかを、社内文書検索AIを例に項目ごとに整理すると、必要になる作業の量と種類がはっきりします。
以下は、同じアプリケーションを「開発チーム5名での検証」から「全社1,000名への公開」へ移す場合の比較です。
(数値は説明のための仮定であり、一般的な推奨値ではありません)
観点 | PoC段階 | 本番運用段階 |
|---|---|---|
利用人数 | 開発チーム数名。同時利用はほぼ発生しない | 登録1,000名/ピーク時に数十件が同時到達する想定 |
入力データ | 代表的な文書を数百件だけ投入 | 全部署の文書。更新・削除・追加が日々発生する |
応答時間 | 「待てば返ってくる」で許容 | 目標値を数値で定義し、遅い側(p95)まで測定する |
障害対応 | 開発者が手元で再起動 | 検知・通知・一次対応の手順と担当者を事前に決める |
更新方法 | 手元でコードを書き換えて再実行 | 更新履歴を残し、失敗時に前の状態へ戻せる仕組みを持つ |
権限管理 | 全員が全文書を参照できる前提 | 原本の閲覧権限を検索・回答にも反映する |
費用管理 | 検証期間中の合計額を後から確認 | 月額予算と処理1件あたりの上限を先に決めて監視する |
表の右列は、そのまま本番移行のタスクリストになります。ただし、すべてを同じ強度で満たす必要はありません。社内限定の利用であれば、夜間の計画停止を許容してコストを抑える判断は十分に成立します。
逆に外部向けサービスであれば、同じ表の「障害対応」と「更新方法」の水準を大きく引き上げることになります。必要水準は用途によって決まるという前提を置いたうえで、各項目の目標値を後述の「本番要件」として言語化していきます。
PoCで測っていない負荷や運用上の課題が表面化する
PoCと本番の差が痛みを伴う形で現れるのが、PoCでは測定していなかった条件下での挙動です。検証時は1件ずつ順番に実行していたため気づかなかった問題が、複数の利用者が同時にアクセスした瞬間に顕在化することがあります。
代表的なものは次の4つです。
- 同時リクエストで待ち時間が急増する
- 再起動でデータが消える
- API制限で処理が失敗する
- 担当者以外が復旧できない
これらはいずれも、モデルの精度とは無関係に発生する運用上の問題です。PoCの評価が「回答品質が良かったので公開しよう」で終わってしまうと、公開後に上記の課題へ対応することになってしまいます。
精度検証と並行して、負荷条件下での応答時間、データの永続性、外部サービスの制限、復旧手順の再現性を確認しておくことが、本番移行の前提になります。
実際のAI開発におけるポイントや注意点はこちらの記事で解説しています。
AIの本番運用を支えるクラウドインフラの基本構成
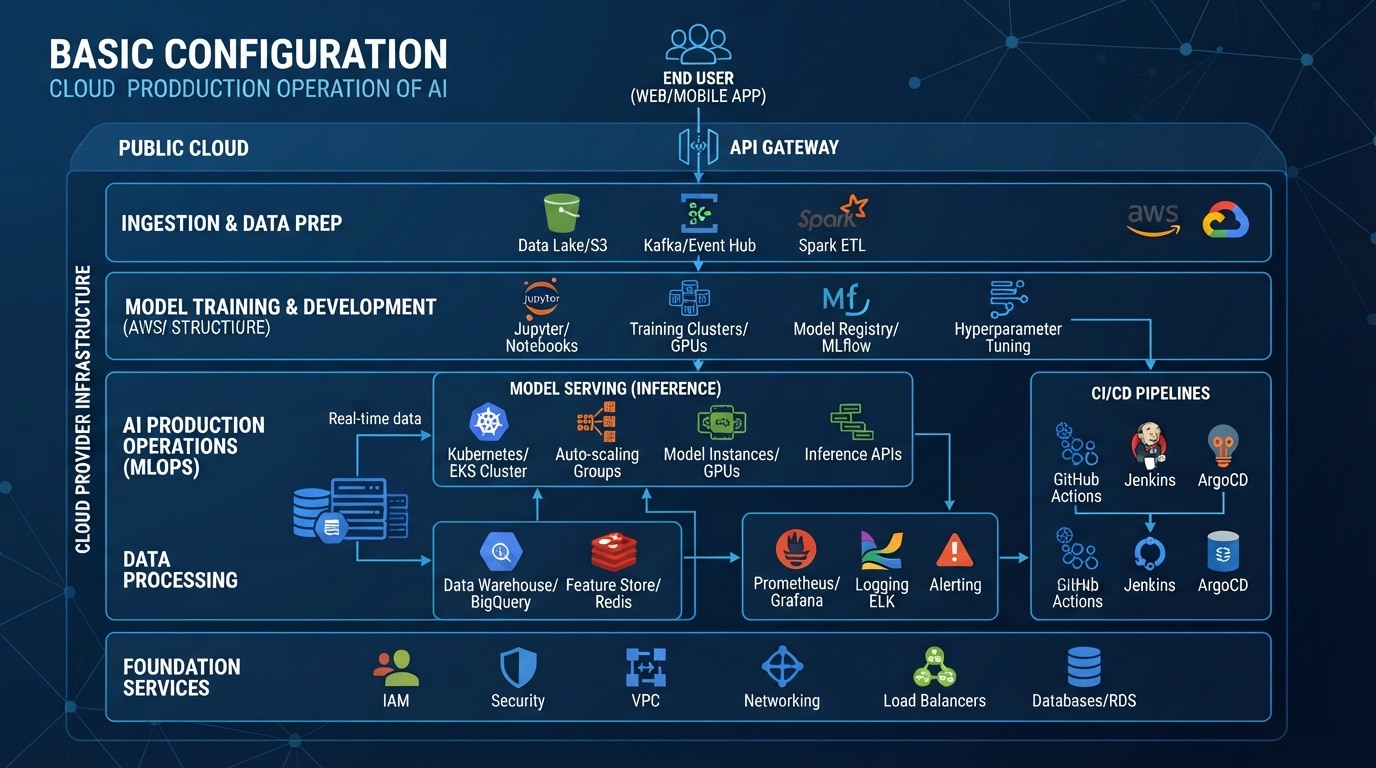
クラウドインフラとは、アプリケーションを動かすために必要な計算・保存・通信の各リソースと、それらを支える仕組みの総称です。
AIアプリケーションの場合も土台は同じで、「どの処理を、どのリソースの上で、どうつないで動かすか」を設計することがインフラ設計の中身になります。
社内文書検索AIを例にすると、本番構成は最低でも次の6つの役割に分解できます。
- 利用者接点:ブラウザや社内チャットツールからのアクセス経路
- 認証:誰がアクセスしているかを確認する仕組み(社内IdPとの連携など)
- アプリAPI:質問を受け取り、検索と生成を組み立てて回答を返す処理
- 検索・データ保存:文書の原本、検索用のベクトルデータ、利用履歴の保管
- 推論先:外部LLM API、マネージド推論サービス、または自社運用のGPU
- 監視・ログ:応答時間やエラー、回答内容を記録し、異常を検知する仕組み
PoCではこれらが1つのスクリプトに同居していることが多く、役割の境界が曖昧なまま動いています。
本番では役割ごとに責務と設定を分けることで、どこで問題が起きているかを特定でき、必要な部分だけを増強・修正できるようになります。以降の章でも、この6要素を共通の枠組みとして参照します。
POINT | 01 |
計算・保存・通信の役割を分けて考える
インフラの検討は、GPUの機種やインスタンスサイズを選ぶところから始めがちですが、先に決めるべきはどの処理をどこで実行し、どのデータをどこに置くかという配置の設計です。計算・保存・通信の3つに分けて整理すると、必要なリソースが自然に導かれます。
区分 | 社内文書検索AIでの中身 | 主な選択肢 |
|---|---|---|
計算 | APIリクエストの処理、文書の検索、回答の生成 | コンテナ実行環境、サーバーレス、仮想マシン、GPUインスタンス |
保存 | 文書の原本、検索用のベクトルデータ、利用履歴・ログ | オブジェクトストレージ、ベクトルDB、リレーショナルDB、ログ基盤 |
通信 | 利用者からアプリへの経路、アプリと保存・推論先の内部通信 | ロードバランサー、プライベートネットワーク、APIゲートウェイ |
このうち計算リソースの選定では、処理の性質ごとに必要なものが異なる点に注意が必要です。APIリクエストの受け付けや検索結果の整形はCPUで十分に処理できますが、自社モデルによる推論はGPUを必要とします。
埋め込み処理は、モデルの規模や処理件数によってCPUでも成立します。すべてを高価なGPUインスタンス上に載せると、GPUが空いている時間帯にも費用が発生し続けることになります。
POINT | 02 |
外部APIと自社モデル運用では推論部分の構成が変わる
推論をどこで実行するかによって、構成図の右半分と、自社が管理する範囲が大きく変わります。
主な選択肢は3つあり、それぞれ確認すべき制限が異なります。
比較項目 | 外部LLM API | マネージド推論サービス | GPUインスタンスで自社運用 |
|---|---|---|---|
モデルの配置先 | 提供事業者の環境 | クラウド事業者の推論基盤 | 自社が確保したGPU上 |
自社の管理範囲 | APIキー管理、リトライ制御、入力内容の設計 | モデルの選択・デプロイ設定・スケーリング設定 | OS、推論サーバー、モデル本体、GPUの割り当て、監視まで |
主に確認すべき制限 | レート制限、利用可能なモデルとその提供終了時期、データの取り扱い条件 | 対応モデル、リージョン、同時実行数の上限、コールドスタート | GPUの在庫・確保可否、VRAM容量、起動時間、ドライバ互換性 |
費用の発生の仕方 | 従量課金(トークン単位)で利用量に比例 | 従量課金または稼働時間課金 | 稼働時間課金。アイドル時間にも費用が発生 |
向いているケース | 利用量の変動が大きい/早く公開したい | 自社モデルを使いたいが運用工数を抑えたい | 特定モデルの継続利用、データを外部に出せない要件がある |
ここで押さえておきたいのは、外部APIを使う場合でも、インフラ設計が不要になるわけではないという点です。推論部分を外部に任せられても、アプリAPI、文書の保存、認証と権限管理、監視、そしてAPI障害時の挙動は自社で設計する必要があります。構成図の6要素のうち、外部化できるのは「推論先」の1つだけだと考えます。
POINT | 03 |
クラウド事業者と自社の管理範囲を確認する
クラウドを使う際に必ず確認すべきなのが、どこまでを事業者が管理し、どこからが自社の責任範囲かという切り分けです。主要クラウドは「責任共有モデル」としてこの境界を明示しており、事業者はデータセンターやハードウェアなど「クラウドのセキュリティ」を担い、利用者はその上で動かすOS・アプリケーション・データ・権限設定など「クラウド内のセキュリティ」を担うという整理になっています。
重要なのは、この境界線が利用するサービスの種類によって動くことです。同じクラウド上のサービスでも、仮想マシンとマネージドサービスとでは自社の責任範囲が変わります。
管理項目 | GPUインスタンス(IaaS) | マネージド推論サービス | 外部LLM API |
|---|---|---|---|
物理設備・ハードウェア | 事業者 | 事業者 | 事業者 |
ホストOS・ハイパーバイザー | 事業者 | 事業者 | 事業者 |
ゲストOSの更新・パッチ適用 | 自社 | 事業者 | 事業者 |
推論サーバー・ライブラリの更新 | 自社 | 事業者(設定は自社) | 事業者 |
アプリケーションの脆弱性対応 | 自社 | 自社 | 自社 |
アクセス権限(IAM)の設定 | 自社 | 自社 | 自社 |
データの暗号化・保存先の選択 | 自社 | 自社(設定範囲内) | 自社(送信可否の判断) |
バックアップの取得・復元手順 | 自社 | 設定による | 自社(自社側データ) |
表を見ると、どの方式を選んでもアプリケーションの脆弱性対応と権限設定は自社に残ることが分かります。
クラウドインフラの設計前に決める本番要件
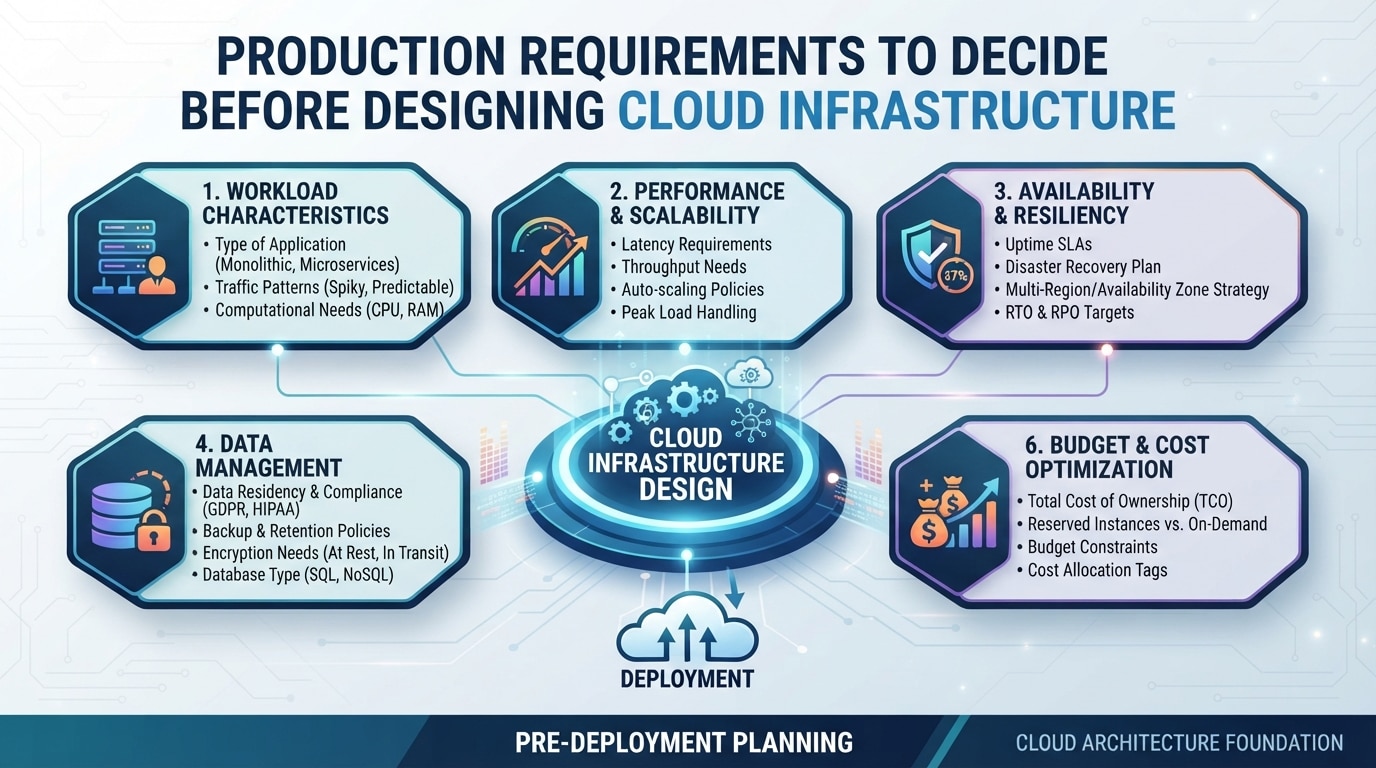
構成を検討する前に、満たすべき条件を数値と文章で確定させることが必要です。要件が曖昧なままインスタンスサイズや冗長化構成を選ぶと、過剰な構成で費用が膨らむか、逆に公開後に性能不足が判明するかのどちらかになります。
以下は社内文書検索AIを想定した本番要件の記入例です。数値はすべて説明のための仮定であり、一般的な推奨値ではありません。
要件項目 | 記入例 | 決め方のポイント |
|---|---|---|
利用時間 | 平日8:00〜20:00。夜間・休日は縮退運転を許容 | 24時間必須か、計画停止を許容できるかを最初に決める |
ピーク負荷 | 登録1,000名。ピーク時の同時リクエスト30件 | 登録者数ではなく同時実行数で見積もる |
応答時間 | 最初の1文字まで3秒以内、回答完了まで15秒以内(いずれもp95) | 平均値だけでなく遅い側の値で定義する |
データの扱い | 原本は国内リージョンに保管。外部APIへは本文抜粋のみ送信。ログは90日保持 | 保存地域・外部送信可否・保存期間の3点を明記 |
復旧目標 | RTO 4時間以内、RPO 24時間(前日のバックアップ時点まで) | 業務が止まって困る時間から逆算する |
予算 | 月額30万円以内。回答1件あたり15円以内 | 推論費用だけでなく保存・通信・監視を含める |
担当者 | 一次対応:情報システム/エスカレーション:開発チーム | 対応時間帯まで含めて決める |
この表を埋める作業自体が、関係部署との合意形成のプロセスになります。特に「利用時間」「復旧目標」「予算」は、開発チームだけでは決められません。要件が確定して初めて、「冗長構成は必要か」「GPUを常時起動しておくべきか」といったインフラの判断が可能になります。
クラウドGPUの料金に関しては、こちらの記事で詳しく解説しています。
AIを安定して動かすクラウドインフラの設計ポイント
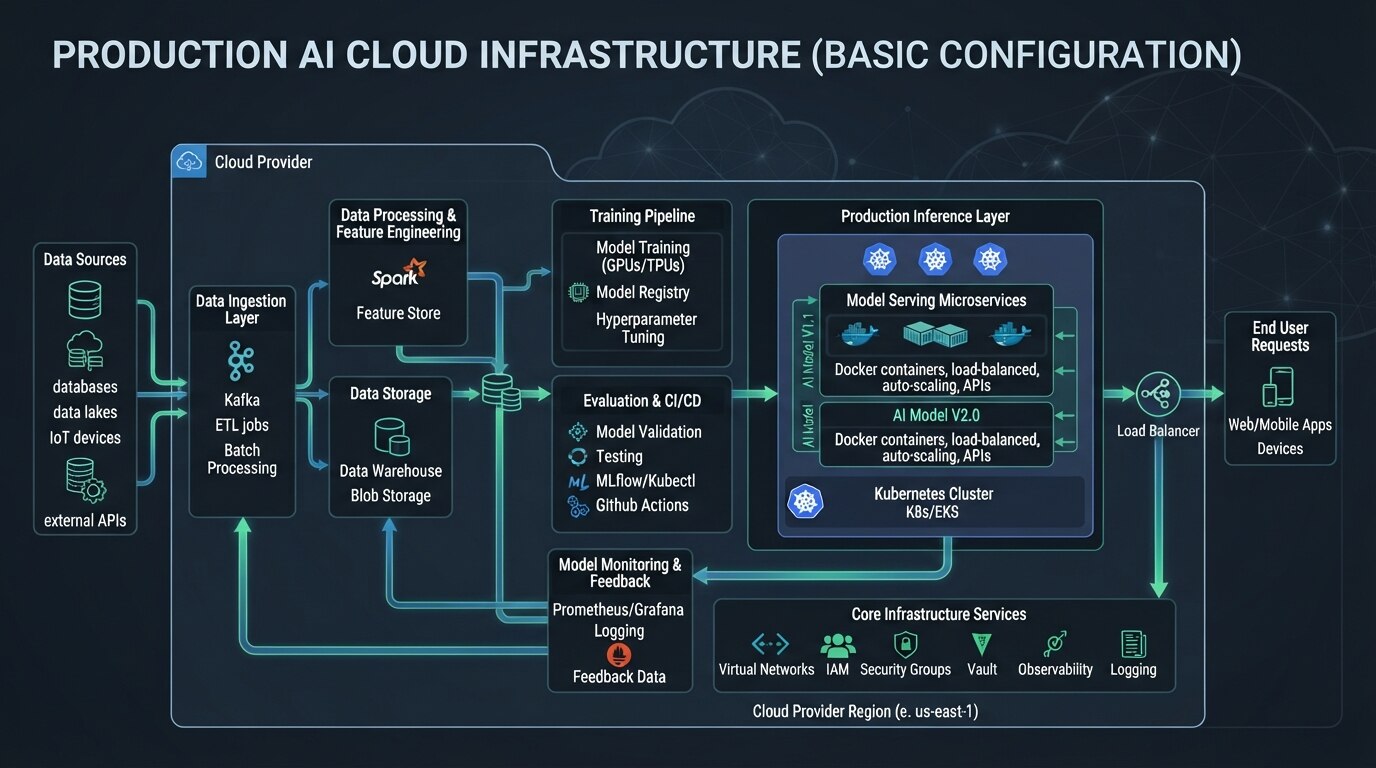
ここからは、前章で決めた要件を具体的な構成と設定に落とし込む段階です。要件が「p95で15秒以内」「RTO 4時間」といった目標である一方、設計は「どのコンポーネントをどう分け、何を設定し、何を確認するか」という実装の話になります。
以下の5つの観点は、いずれもPoC段階では省略されがちで、かつ本番で問題が起きたときに後から入れるのが難しいものです。各項目は「起こる問題 → 設計方法 → 確認項目」の順に整理しています。
API・推論処理・データ保存を分ける
負荷の原因に合わせて増強・非同期化を選ぶ
認証・権限管理とネットワークの公開範囲を設定する
インフラの状態とAIの回答品質を監視する
環境を再現し、更新に失敗したら戻せるようにする
設計ポイント | 01 |
API・推論処理・データ保存を分ける
PoCのコードでは、APIの受け付け、ベクトル検索、推論呼び出し、データ保存が1つのプロセス内で完結していることが多くあります。この状態のまま本番に持っていくと、推論部分の負荷対策としてインスタンスを増やしたときに、それぞれのインスタンスが別々のローカルデータを持ってしまい、回答が一貫しなくなります。
まず、アプリAPIをステートレスに保ちます。ステートレスとは、サーバー側がリクエスト間の状態を保持せず、必要な情報はすべてリクエストと外部のデータストアから得られる状態を指します。
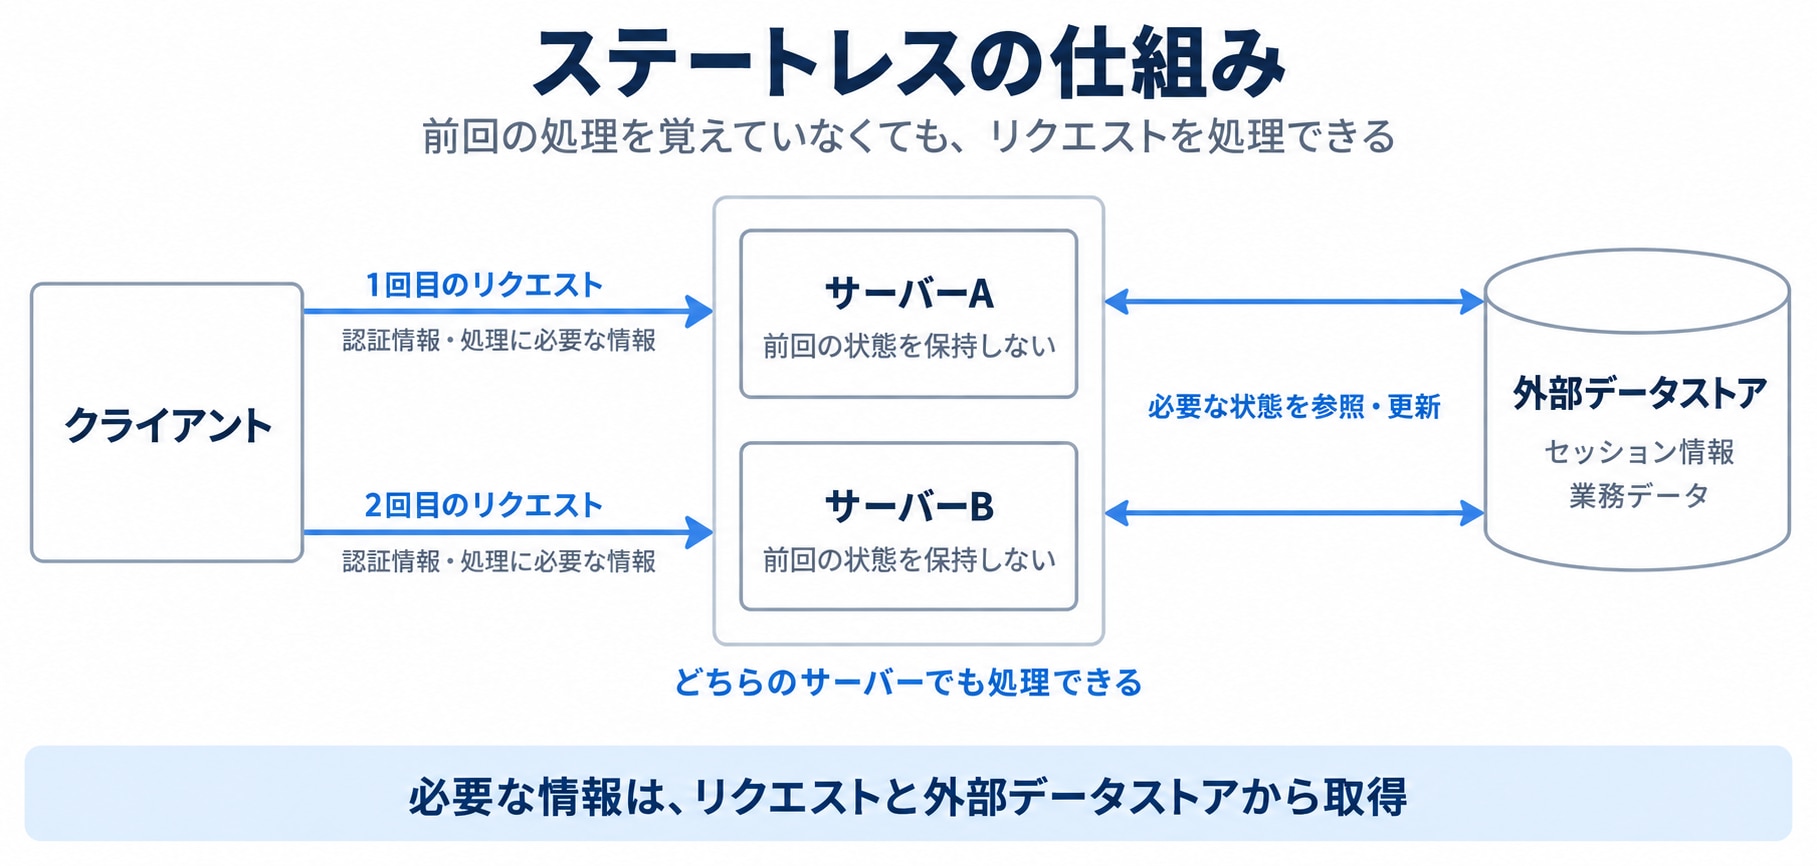
この性質があると、どのインスタンスがリクエストを受けても同じ結果を返せるため、台数の増減や再起動が安全に行えます。
具体的には次のように配置します。
- 永続データは外部のマネージドサービスへ
- コンテナの一時領域はキャッシュ用途に限定
- モデルの重みは共有ストレージまたはイメージに含める
ここで注意したいのは、論理的な責務分離と、物理的にサーバーを分けることは別だという点です。小規模なうちは、アプリAPIと検索処理を同じインスタンス上のプロセスとして動かしつつ、データだけを外部に出す構成でも十分に成立します。
設計ポイント | 02 |
負荷の原因に合わせて増強・非同期化を選ぶ
「遅い」という症状の原因は複数あり、原因を特定せずにインスタンスを増やしても改善しないことがあります。GPUメモリが不足しているときに台数を増やせば費用だけが増え、外部APIの制限に当たっているときにGPUを増強しても効果はありません。
まず症状から原因の候補を絞り込みます。以下は社内文書検索AIでよく見られる症状と、調査・対処の対応表です。
症状 | 調査する対象 | 対処の候補 |
|---|---|---|
推論時に | ・GPUのVRAM使用量 | VRAM容量の大きいGPUへ変更、量子化モデルの採用、同時実行数の上限設定、入力長の制限 |
応答が全体的に遅く、待ち行列が伸びる | ・推論エンジンのキュー長 | GPUインスタンスの増設、バッチ処理設定の調整、より高速なGPUへの変更 |
検索・文書読み込みの段階で時間がかかる | ・ベクトル検索の所要時間 | インデックスの見直し、取得チャンク数の削減、頻出クエリのキャッシュ |
| ・外部APIのレート制限値 | 指数バックオフによる再試行、送信量の平準化、上限緩和の申請、フォールバック先の用意 |
特定の時間帯だけ遅い | ・時間帯別のリクエスト数 | スケジュールに基づく事前増設、自動スケーリングのしきい値調整 |
自社モデルを運用する場合、VRAM容量が同時実行数の上限を直接決める点は押さえておく価値があります。モデルの重みだけでも、パラメータ数×1パラメータあたりのバイト数が必要で、bfloat16なら70Bクラスのモデルで140GB程度のVRAMが目安になります。
実際にはこれに加えて、同時実行数と入力長に比例して増えるKVキャッシュの領域が必要です。モデルサイズによっては複数GPUへの分割が前提になります。
設計ポイント | 03 |
認証・権限管理とネットワークの公開範囲を設定する
PoCでは検証を優先して、推論サーバーやデータベースをインターネットから直接アクセスできる状態にしたり、APIキーをコードに直接書き込んだりすることがあります。
この状態で公開すると、認証を経ないアクセスや、リポジトリからの認証情報流出につながります。設計方法では、外部に開く入口を1つに絞ることが基本方針です。
- 公開する入口を限定する
- 内部通信も制限する
- 秘密情報は専用の仕組みで管理する
- 権限は最小限から始める
そのうえで、AIアプリケーション特有の注意点として、利用者認証と文書の閲覧権限は別々に確認する必要があります。「社員であることを確認する」ことと、「この社員がこの文書を見てよいか判断する」ことは別の処理です。
社内文書検索AIでは、認証で得た利用者の属性を検索クエリの絞り込み条件に渡し、権限のあるチャンクだけを対象に検索する実装が必要になります。認証だけを実装して認可を省略すると、ログインした全員が全文書の内容を引き出せる状態になります。
設計ポイント | 04 |
インフラの状態とAIの回答品質を監視する
CPU使用率とエラー率だけを監視していると、「システムは正常だが、回答内容が明らかにおかしい」という状態を検知できません。逆に回答品質だけを見ていると、遅延の原因が推論なのか検索なのか通信なのかを切り分けられません。
監視対象をインフラの状態とAIとしての品質の2系統に分けて設計します。
系統 | 監視項目 | 見るべき観点 |
|---|---|---|
インフラ | 応答時間(平均・p95・p99)、エラー率、リクエスト数 | 要件で決めた目標値を満たしているか |
インフラ | 待ち行列の長さ、同時実行数 | 処理能力の限界に近づいていないか |
インフラ | CPU/GPU使用率、VRAM使用量、ストレージ空き容量 | 増強の判断材料。GPUは使用率とVRAMの両方を見る |
インフラ | 外部APIの成功率、レート制限エラー数 | 上限に近づいていないか |
品質 | 検索結果の妥当性(参照文書が質問に関連しているか) | 検索段階で失敗していないか |
品質 | 回答に対する利用者フィードバック(良い/悪い評価) | 更新の前後で悪化していないか |
品質 | 「該当文書なし」と回答した割合 | 急増していれば検索データ側の問題を疑う |
コスト | 日次の費用、処理1件あたりの費用 | 予算超過の予兆を早期に捉える |
切り分けを可能にするために、リクエストIDによる追跡を組み込みます。利用者からのリクエストごとに一意のIDを発行し、認証、検索、推論、応答生成の各段階のログに同じIDを記録します。
一方で、入力全文を無条件にログへ保存することは避けてください。社内文書検索AIの質問文には、人事情報や取引先名などの機密情報が含まれ得ます。対策としては、ログに残す項目をあらかじめ選定し、本文が必要な場合はマスキング処理と保存期間の上限、閲覧権限の制限をセットで設計します。
設計ポイント | 05 |
環境を再現し、更新に失敗したら戻せるようにする
「担当者の環境では動くが、本番では動かない」「設定変更後に不具合が出たが、変更前の状態が分からない」という状況は、環境とインフラ設定が手作業で構築されている場合に必ず発生します。
AIアプリでは、ライブラリのバージョン差やGPUドライバの違いが挙動に直結するため、影響がより大きくなります。再現性を確保する仕組みは、対象によって役割が分かれます。
対象 | 使う仕組み | 固定できるもの |
|---|---|---|
アプリの実行環境 | コンテナ | OS、Pythonバージョン、依存ライブラリ、CUDA関連の構成 |
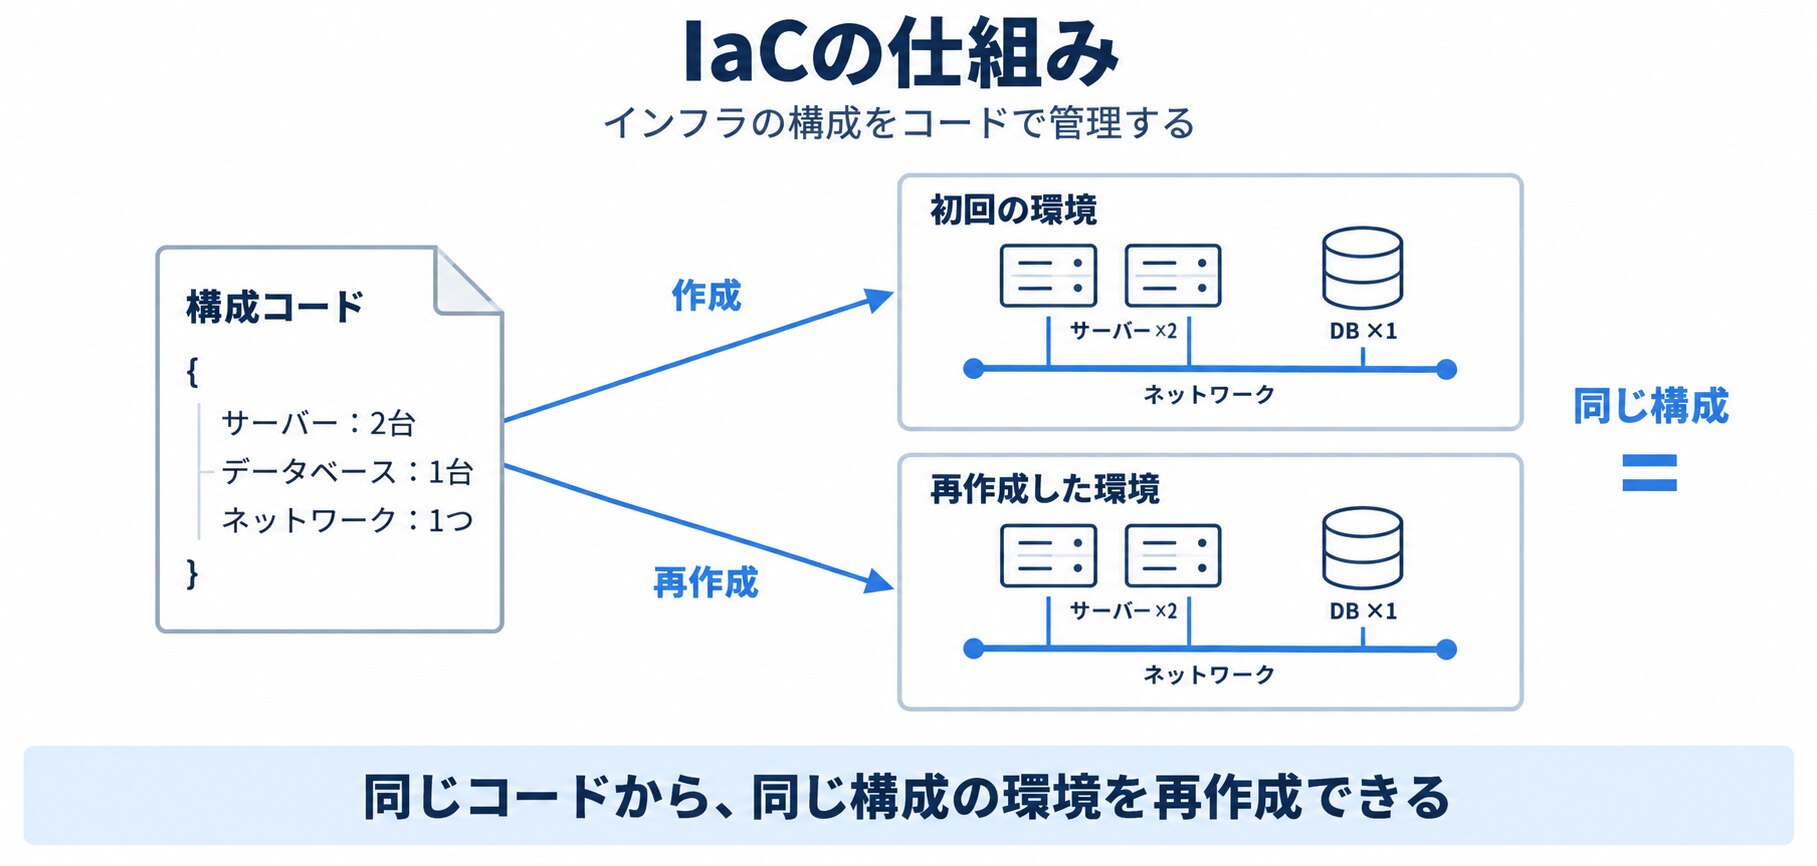
インフラの構成 | IaC(Terraform、CloudFormationなど) | インスタンス種別、ネットワーク、権限設定、監視設定 |
コード | バージョン管理(Git) | アプリケーションのソースコード |
モデル | モデルレジストリまたはバージョン付きストレージ | モデルの重みとバージョン |
IaCは、インフラの構成をコードとして記述し、同じ内容から同じ環境を再作成できるようにする手法です。手順書に沿った手作業と違い、実行結果が一定になり、変更履歴がコードのdiffとして残ります。
そして、RAG構成のAIで見落とされやすいのが、プロンプトと検索用データも変更管理の対象だという点です。回答品質を左右する要素は、コードとモデルだけではありません。
- システムプロンプトの文面
- 取得するチャンク数、チャンクの分割サイズ
- 埋め込みモデルのバージョン
- 検索用データの更新時点
これらの変更履歴が残っていないと、以前に「正しく答えていた質問に答えられなくなった」ときに原因を特定できません。プロンプトはコードと同じリポジトリで管理し、検索用データは再構築した日時とソースの範囲を記録しておきます。
AIをネイティブ開発するにあたって選ぶべきクラウド基盤に関しては、こちらの記事を参考にしてみてください。
PoCから本番運用へ移行する手順
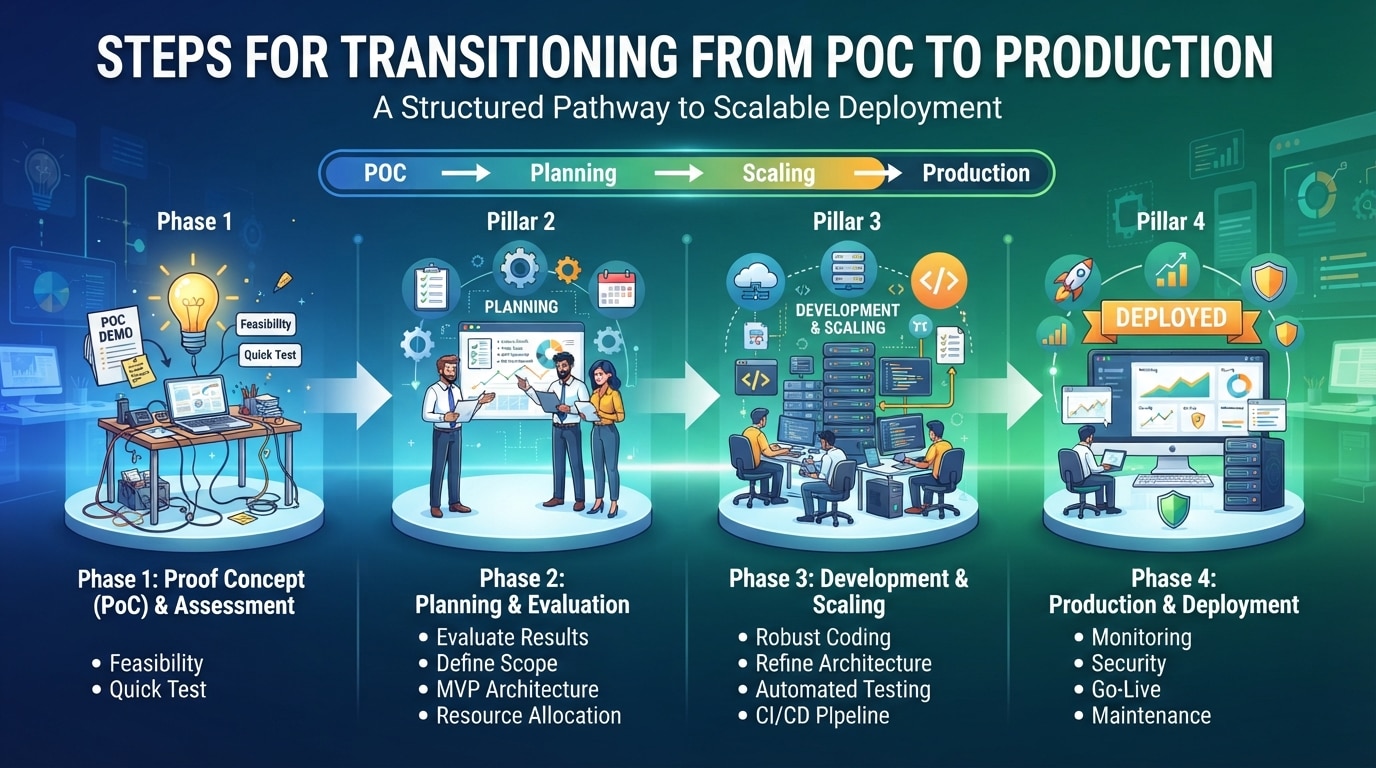
ここまでで、本番に必要な要件と設計の観点が揃いました。
この章では、それらを実際に検証して公開するまでの流れを4つの工程に分けて整理します。
- PoCの構成と本番要件の差分を洗い出す
- 本番と条件をそろえた検証環境を作る
- 負荷・障害・権限・回答品質をテストする
- 利用者を限定して公開し、実測値をもとに広げる
手順
01
PoCの構成と本番要件の差分を洗い出す
最初の工程は、現状の棚卸しです。PoCの構成を要素ごとに書き出し、前章で定めた本番要件と突き合わせて、足りていない部分を一覧化します。棚卸しの対象は次のとおりです。
- コード:どこに保管されているか。バージョン管理されているか
- 依存ライブラリ:バージョンが固定されているか。requirements.txtなどに記録があるか
- モデル:使用しているモデルとバージョン。外部APIならエンドポイントと利用条件
- データ保存先:文書、ベクトルデータ、履歴が現在どこに置かれているか
- 外部サービス:利用しているAPI、認証方式、キーの保管場所、レート制限
- 手作業:起動、データ投入、再インデックス化など、人の操作に依存している手順
洗い出した差分は、そのままタスクリストにせず、「公開前に必要」と「利用拡大後に検討」の2つに分けることを推奨します。すべてを公開前にやろうとすると移行が長期化し、PoCの成果が陳腐化します。
分類 | 判断基準 | 例 |
|---|---|---|
公開前に必要 | 満たさないと事故につながる/後から入れるのが困難 | 権限に応じた検索の絞り込み、秘密情報の管理、データの永続化、バックアップ、基本的な監視 |
利用拡大後に検討 | 現在の利用規模では不要/後から追加できる | 自動スケーリング、複数リージョン構成、高度な負荷分散、キャッシュ層の追加 |
そのうえで、各タスクに担当者と期限を割り当てます。この工程の成果物は「差分の一覧」ではなく「担当者が決まったタスクリスト」です。
手順
02
本番と条件をそろえた検証環境を作る
次に、テスト結果が本番の予測として使える環境を用意します。ここでの目的は「動くことの確認」ではなく「本番で起きることの予測」なので、結果を左右する条件を本番に近づけることが重要です。
以下の項目がずれていると、テストの意味が薄れてしまいます。
条件 | そろえないと起きること |
|---|---|
認証・権限設定 | 権限による絞り込みの不具合を検知できない |
ネットワーク構成 | 本番でのみ通信が遮断される、レイテンシが想定と異なる |
モデルとバージョン | 応答時間、VRAM使用量、回答品質がすべて変わる |
データ量 | 検索時間が本番で大幅に伸びる |
インスタンス種別・GPU | 性能測定の結果が本番に適用できない |
一方で、機密データをそのまま複製することは避けてください。検証環境は本番より権限管理が緩いことが多く、複製した時点で情報が漏れる経路が増えます。対応としては、件数や文書の長さといった負荷に影響する特性を保ったまま、氏名・取引先名などを匿名化したデータを用意します。
権限テストのために、権限の異なるテストユーザーを複数用意しておくと効率的です。
手順
03
負荷・障害・権限・回答品質をテストする
検証環境が整ったら、通常の動作確認では見つからない問題を洗い出すテストを実施します。以下は社内文書検索AIを想定した公開前チェックリストです。
要件に合わせて以下の項目を調整してみてください。
負荷
- ピーク時の同時実行数で、応答時間が目標値(p95)以内に収まる
- ピークの1.5倍の負荷をかけたとき、エラーを返すのか待機するのか、挙動が想定どおり
- 長時間の連続負荷でメモリリークやVRAMの解放漏れが起きない
障害
- 外部APIがレート制限を返したとき、リトライまたはエラー表示が想定どおり動く
- 推論サーバーを停止させたとき、利用者に適切なメッセージが表示される
- バックアップから実際に復元でき、所要時間がRTO内に収まる
- 直前のバージョンへ切り戻しでき、所要時間がRTO内に収まる
権限・セキュリティ
- 権限のない文書について質問したとき、内容が回答に含まれない
- インターネットから推論サーバー・DBに直接アクセスできない
- リポジトリと環境変数に認証情報が平文で含まれていない
- ログに機密情報が残っていない
回答品質
- 代表的な質問セットで、更新前後の回答を比較して劣化がない
- 検索でヒットすべき文書が上位に来る
- 該当文書がない質問に対して、推測ではなく「見つからない」と回答する
費用
- 負荷テスト時の実測費用から、通常時・ピーク時の月額を試算して予算内に収まる
- 予算アラートが設定され、しきい値超過時に通知が届く
ここで回答品質のテストを負荷・障害テストと同列に扱うことが、AIアプリケーション特有のポイントです。インフラの変更(推論エンジンの設定変更、量子化モデルへの切り替え、取得チャンク数の削減など)は回答内容に影響します。「速くなったが答えが雑になった」という変化を検知するために、固定の質問セットで前後比較する仕組みを用意しておきましょう。
手順
04
利用者を限定して公開し、実測値をもとに広げる
テストを通過しても、実際の利用者の使い方は予測を超えます。想定より長い質問、想定していなかった文書の探し方、業務のピークと重なるアクセスなど、検証環境では再現できない条件が出てきます。
そのため、最初から全社公開せず、特定部署など限定した範囲から始めることを推奨します。限定公開の期間中は、次の4点を継続的に確認します。
確認項目 | 見る指標 | 判断の材料 |
|---|---|---|
エラー | エラー率、エラーの種類と発生箇所 | 特定の操作で再現するか、単発か |
応答時間 | p95応答時間、時間帯別の推移 | 目標値を満たしているか、ピーク時に悪化しないか |
回答品質 | 利用者フィードバック、「見つからない」率 | 検索データの不足か、プロンプトの問題か |
費用 | 1件あたりの実測費用、日次の合計 | 試算とのずれ。想定より入力が長くないか |
そして重要なのが、公開範囲を広げる条件と、停止・切り戻しの条件を事前に決めておくことです。
条件を満たしたら段階的に対象部署を広げ、その都度同じ指標を確認します。各段階で実測してから次へ進むという進め方が、結果として最短の移行になります。
次にやるべきは、要件の言語化と実機検証

PoCを本番運用へ進めるうえで必要なのは、より高性能なGPUや複雑な構成ではありません。継続利用の条件を数値と文章で決め、それを満たせる構成を実際に検証することです。
最初の一歩として、本記事の本番要件の記入例をもとに自社の値を埋め、PoCの現状構成との差分を洗い出してみてください。差分を「公開前に必要」と「利用拡大後に検討」に分けるだけでも、次に着手すべき作業がはっきりします。
そのうえで自社モデルの運用を検討する場合は、想定するモデルと負荷条件でクラウドGPUの性能を実測し、VRAMと応答時間の見通しを立てることが、確実な本番移行につながります。
NVIDIA H200を搭載したGPUが、業界最安値で使える!
実測環境を用意する際は、GPUSOROBANのような従量課金型のGPUクラウドを使うと、初期投資を抑えながら本番相当の条件で検証できます。GPUSOROBANはNVIDIAの高性能GPUインスタンスを1時間単位で利用でき、停止中は課金されないため、負荷試験のような短期集中の検証にも向いています。サービス概要や料金体系、導入事例をまとめた資料を無料でダウンロードできますので、本番移行の検討材料としてぜひご活用ください。