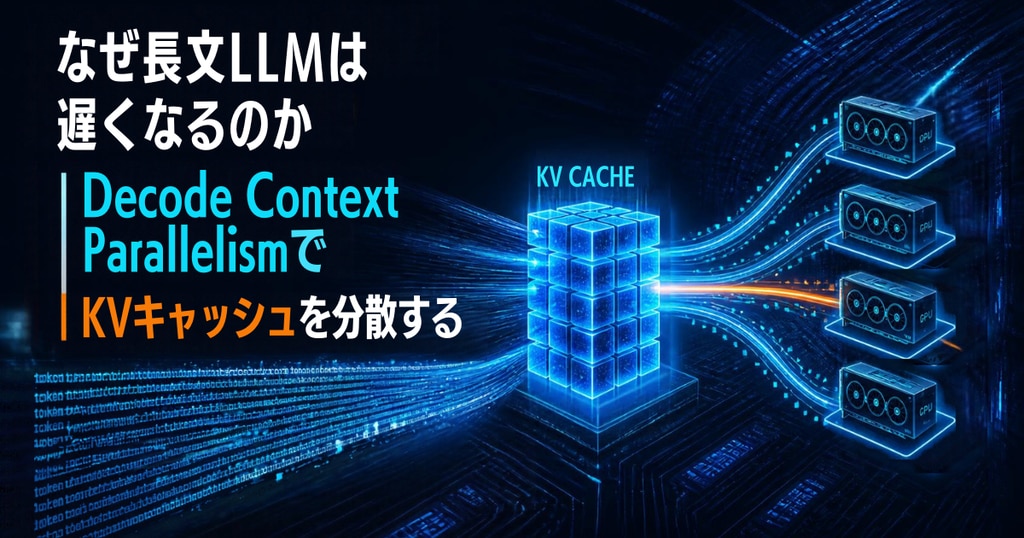
なぜ長文LLMは遅くなるのか|Decode Context ParallelismでKVキャッシュを分散する
長文LLMが遅くなる原因をPrefillとDecodeに分けて整理し、GQA・MLAモデルでTensor ParallelismがKVキャッシュを重複させる仕組みと、vLLMのDecode Context Parallelism(DCP)による解消方法・設定例・導入判断基準を解説する。
記事を見る
長文LLMが遅くなる原因をPrefillとDecodeに分けて整理し、GQA・MLAモデルでTensor ParallelismがKVキャッシュを重複させる仕組みと、vLLMのDecode Context Parallelism(DCP)による解消方法・設定例・導入判断基準を解説する。
記事を見る
GPUSOROBAN 計算クラスターのグループ機能と管理者の役割を説明します。共通のポイントやストレージを使う仕組み、グループの作成・メンバーの招待手順、チームで利用する際の注意点を確認できます。
記事を見るGPUSOROBAN 計算クラスターでジョブを実行する際のポイント引き落としルールを説明します。個人・グループのどちらのポイントが使われるか、実行中に引き落とし元を変更する条件と注意点を確認できます。
記事を見るGPUSOROBAN 計算クラスターの個人・グループストレージの違いと料金を説明します。容量に応じた日次のポイント消費、初回の無償ポイント付与、引き落とし先、グループ利用時の準備を確認できます。
記事を見るGPUSOROBAN 計算クラスターのGPU利用時に消費するポイントの計算ルールを説明します。GPU枚数とジョブの実行時間による料金計算、課金対象となるジョブの状態、利用時の注意点を確認できます。
記事を見る