Speculative Decodingとは?出力精度を変えずにLLM推論を高速化する仕組み
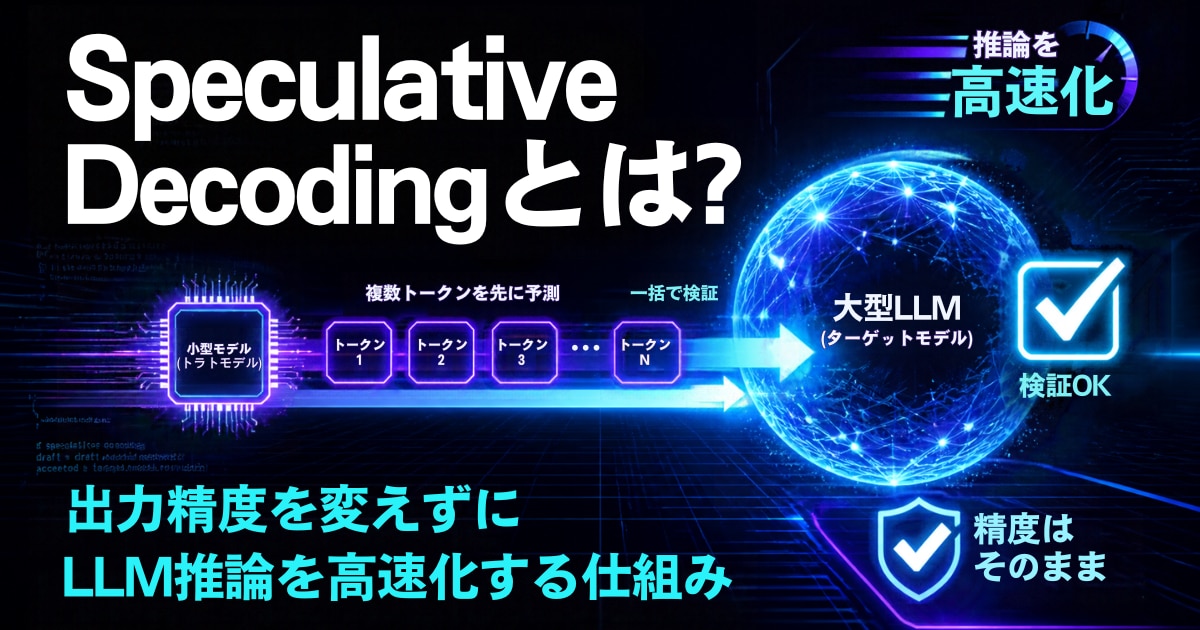
Speculative Decoding(投機的デコーディング)は、LLMの出力分布を変えずに、生成を速くする推論手法です。
小さく速いモデルが先に複数のトークン候補を出し、本命の大きなモデルがそれをまとめて検証します。
「LLMの応答が遅い」「GPUを増やさずにレイテンシを下げたい」というときに、量子化やKVキャッシュと並んで候補に挙がる手法です。ただし、ドラフトモデルの選び方や候補数の設定を誤ると、かえって遅くなることもあります。
この記事では、次の内容を解説します。
通常の自己回帰生成や、量子化・KVキャッシュ・バッチ処理との違い
ドラフト→一括検証→採択・棄却という仕組みと、出力精度が変わらない理由
Draft-Target・MTP・EAGLE系・N-gramといった主な方式
速くなる条件と遅くなる条件
vLLMでの導入手順と、検証に使うGPU環境の選び方
※設定例は、2026年11月時点のvLLM公式ドキュメント(開発版)を基にしています。設定キーや対応方式はバージョンで変わるため、利用中のバージョンのドキュメントもあわせて確認してください。
NVIDIA H200を搭載したGPUが、業界最安値で使える!
最先端のNVIDIA H200を、業界最安値クラスでご提供。学習・推論のスピードはそのままに、GPUコストを大幅圧縮。生成AI・LLM学習・シミュレーションなど大規模計算に最適。オンプレミスや他社クラウドと比べても圧倒的に低コストで、最新GPUを手軽に利用できます。
目次[非表示]
- 1.Speculative Decodingとは?
- 2.Speculative Decodingの仕組み
- 3.Speculative Decodingの主な方式
- 4.Speculative Decodingが速くなる・遅くなる条件
- 4.1.ドラフトの速さと採択長のバランス
- 4.2.GPUの負荷の高さ
- 4.3.メモリの余裕
- 5.vLLMでSpeculative Decodingを導入する手順
- 5.1.対応方式・モデル・実行環境を確認する
- 5.2.Speculative Decodingなしのベースラインを測る
- 5.3.speculative_configを設定して生成する
- 5.4.候補数と同時接続数を変えて最適値を探す
- 6.Speculative Decodingを試すGPU環境の選び方
- 6.1.VRAM:ターゲットとドラフトの重み+KVキャッシュで見積もる
- 6.2.メモリ帯域:デコードの速さを決める
- 6.3.GPU枚数と接続:テンソル並列で分割するか
- 6.4.ソフトウェア環境:CUDAとドライバのバージョン
- 7.Speculative Decodingのまとめ
Speculative Decodingとは?
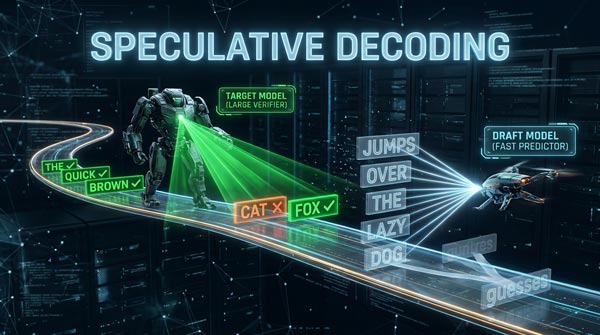
Speculative Decodingとは、1回のforward(順伝播計算)で複数トークンを確定させる推論高速化の手法です。
通常はターゲットモデル(本命の大きなモデル)が1トークンずつ生成しますが、これを「先読みした候補をまとめて検証する」処理に置き換えます。
なお、「出力精度を変えない」とは、ターゲットモデルの出力確率分布を保つという意味です。
temperature>0でサンプリングする場合、生成される文字列自体は毎回変わり得ます。一致するのは個々の文字列ではなく、文字列が引かれる確率分布です。
この手法は、2022~2023年にほぼ同時期に2つの論文で提案されました。
提案 | 検証したモデル・環境 | 報告された高速化 |
|---|---|---|
GoogleのLeviathanら | T5-XXL(標準的なT5X実装と比較) | 2~3倍 |
DeepMindのChenら | 分散環境で動かしたChinchilla 70B | 2~2.5倍 |
※数値はいずれも各論文の要旨より。どちらも、採択・棄却の規則を工夫することで、ターゲットモデル単体と同じ出力分布になることを数学的に示しています。
通常の自己回帰生成との違い
通常のLLMは、自己回帰(autoregressive)で文章を作ります。
今までのトークン列を入力し、次の1トークンを決める
そのトークンを末尾に足す
1~2を繰り返す
そのため、100トークン生成するにはターゲットモデルのforwardが100回必要です。
Speculative Decodingでも、トークンが1つずつ順番に決まる点は変わりません。違うのは、候補列が先に与えられている点です。
たとえば「東京 の 天気 は」の続きとして、候補「晴れ / です / 。」があるとします。ターゲットモデルは1回のforwardで、次の3つの分布をまとめて計算できます。
位置1:「東京 の 天気 は」の次に来るトークンの分布
位置2:「東京 の 天気 は 晴れ」の次に来るトークンの分布
位置3:「東京 の 天気 は 晴れ です」の次に来るトークンの分布
つまり、文章全体を一括で生成しているわけではありません。複数ステップ分の判定を1回のforwardにまとめているのがポイントです。
量子化・KVキャッシュ・バッチ処理との違い
Speculative Decodingは、ほかの推論最適化と狙いが異なり、多くの場合は併用できます。
手法 | 何を変えるか | 主な狙い | 出力への影響 | 併用 |
|---|---|---|---|---|
Speculative Decoding | forward回数 | レイテンシ短縮 | 分布を保つ | — |
量子化 | 重み・活性値の数値表現 | メモリ削減・高速化 | 変わる可能性あり | 可能 |
KVキャッシュ | 計算済みKey/Valueの再利用 | 同じ計算を省く | 変わらない | 前提として併用 |
バッチ処理 | 複数リクエストの同時処理 | スループット向上 | 原則変わらない | 可能 |
ターゲットを量子化した場合は、「精度が変わらない」の意味に注意が必要です。
Speculative Decodingが保つのは、実際に動かしているターゲットモデルの分布
FP8に量子化したモデルがターゲットなら、比較対象は元のFP16モデルではなく、量子化後のモデル単体
量子化による精度の変化と、Speculative Decodingによる高速化は、分けて評価しましょう。
KVキャッシュの仕組みは、こちらの記事を参考死してみてください。
Speculative Decodingの仕組み
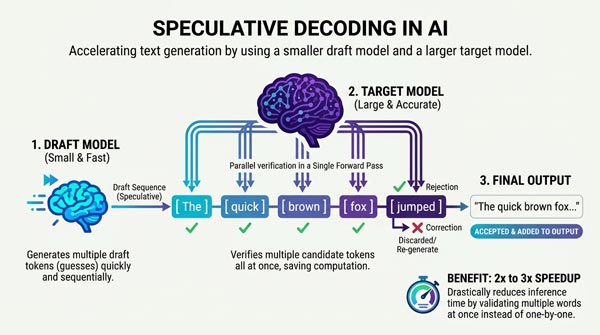
Speculative Decodingは、次の3段階を1サイクルとして繰り返します。
ドラフトが候補を出す
ターゲットがまとめて検証する
採択・棄却で確定する
確定したトークンを文脈に足し、次のサイクルの候補を作ります。1サイクルで確定するトークン数は、最小1、最大γ+1です。
この記事では、記号を次のように統一します。
記号 | 意味 |
|---|---|
p | ターゲットモデル(本命の大きなモデル)の次トークン分布 |
q | ドラフトモデル(候補を出す小さなモデルなど)の次トークン分布 |
γ | 1サイクルでドラフトが出す候補トークン数。vLLMのnum_speculative_tokensに相当 |
仕組み | 01 |
ドラフトモデルが複数の候補トークンを先読みする
最初に、ドラフトモデルが現在の文脈に続く候補をγ個生成します。
ドラフトモデルも一般的には自己回帰モデルなので、候補1→候補2→候補3…と順番に生成します。
x₁ ~ q(・| prefix)、x₂ ~ q(・| prefix, x₁)、…、xγ ~ q(・| prefix, x₁, …, xγ−1)
ここで押さえたいのは、先読み自体の計算は無料ではない点です。ドラフトのforwardはγ回発生し、各位置の分布q(x)も後の判定用に保持します。
候補数γを増やしたときの影響は、次のとおりです。
1サイクルで確定できるトークン数の上限は増える
ドラフトの計算時間は、γに比例して増える
後ろの候補ほど採択されにくい(それより前の候補がすべて採択されていることが前提のため)
各位置の条件付き採択率が一定でも、先頭からk個が連続で採択される確率はそれらの積になり、後ろの位置ほど小さくなります。γは大きいほど速い、というものではありません。
仕組み | 02 |
ターゲットモデルが候補をまとめて検証する
次に、ターゲットモデルが「確定済みの文脈+γ個の候補」を入力し、1回のforwardでγ+1個の位置の分布を計算します。
p(・| prefix)、p(・| prefix, x₁)、…、p(・| prefix, x₁, …, xγ)
Transformerのcausal attentionはそのまま保たれる
位置kの分布は「k番目までの候補」だけを見て計算され、1トークンずつ生成した場合と同じ値になる
処理の形は、プロンプトを読み込むprefillとよく似ている
注意したいのは、forwardは1回でも、処理するトークンはγ+1個分なので計算量は増えるという点です。
それでも速くなるのは、LLMのデコードが多くの場合、計算量ではなくメモリ帯域に律速されているからです。
デコードでは、1ステップごとにモデル重み(数GB~数百GB)の多くをGPUメモリから演算器へ読み出す
バッチが小さいと演算器は読み出し待ちが長く、計算能力に余裕がある
複数トークンを1回のforwardで処理すれば、重みの読み出しコストを複数トークンで分け合える
※実際の転送量は、実装やキャッシュの効き方によって変わります。
ただし、次のような場合は検証時間が目に見えて伸びることが確認できます。
γが大きい
文脈が長く、attentionの計算が重い
バッチが大きく、計算律速に近い
仕組み | 03 |
採択・棄却と再サンプリングで出力を確定する
最後に、ドラフトの候補を先頭から1つずつ判定し、出力を確定させます。判定方法はデコード方式によって異なります。
- greedy(temperature=0)の場合
各位置で、ターゲットが最も確率が高いと判断したトークン(argmax p)とドラフトの候補を比べます。
先頭から一致している候補は、すべて採択
最初に不一致となった位置では、ターゲットのargmaxのトークンを代わりに採用
結果は、ターゲット単体でgreedy生成した場合と同じトークン列になります。
- sampling(temperature>0)の場合
候補xᵢは、次の確率で採択します(本記事では「採択確率」と呼びます。受理確率、acceptance probabilityとも呼ばれます)。
αᵢ = min(1, p(xᵢ) / q(xᵢ))
ターゲットの方が確率を高く見積もっているトークン(p(x)≧q(x))は、必ず採択
ドラフトが過大に見積もったトークンは、その比率に応じて棄却
棄却した場合は、次の分布からトークンを1つ引き直します。
p′(x) = max(0, p(x) − q(x)) / Σx′ max(0, p(x′) − q(x′))
この分布は、「ドラフトは出しにくいが、ターゲットは出したい」トークンの分だけを補うものです。採択分と引き直し分を合わせると、ちょうどターゲットの分布pに一致します。
これが「出力精度を変えずに速くなる」根拠です。
どちらの方式にも共通するルール
最初に棄却が起きた位置より後ろの候補は、すべて破棄する(正しくない文脈を前提に作られているため)
γ個すべてが採択された場合は、②で計算済みの分布からもう1トークン引けるため、γ+1トークンが確定する
途中でEOSなどの終了トークンが出たり、最大長に達したりした場合は、そこで終了する
一連の流れを擬似コードにすると、次のとおりです。
def speculative_step(prefix, gamma):
# ① ドラフトがγ個の候補を自己回帰で生成し、各位置の分布qを保持
drafts, q = [], []
for _ in range(gamma):
dist_q = draft_model(prefix + drafts)
drafts.append(sample(dist_q))
q.append(dist_q)
# ② ターゲットが1回のforwardでγ+1個の位置の分布pを計算
p = target_model.forward_all_positions(prefix, drafts) # len(p) == gamma + 1
# ③ 先頭から採択・棄却を判定
accepted = []
for i, x in enumerate(drafts):
if random() < min(1.0, p[i][x] / q[i][x]):
accepted.append(x)
if x == EOS:
return accepted
else:
residual = normalize(max(p[i] - q[i], 0))
accepted.append(sample(residual)) # 引き直して終了。以降の候補は破棄
return accepted
# 全候補が採択されたら、ターゲットから追加で1トークン
accepted.append(sample(p[gamma]))
return accepted
※この擬似コードは、仕組みを示すための簡略版です。
max(p[i] - q[i], 0)は、語彙全体の確率ベクトルに対する要素ごとの演算
normalize、sample、forward_all_positionsは概念上の関数
EOSや最大長などの終了条件は簡略化し、greedy時の判定やバッチ処理は省略
こちらの記事からは、PyTorchの基本を学ぶことができます。
Speculative Decodingの主な方式
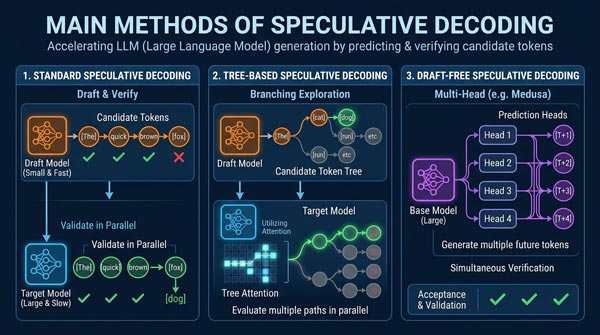
方式は、「候補を誰がどう作るか」で分かれます。
検証と採択・棄却の考え方は共通です。違うのは、ドラフトの作り方と、追加で必要になるモデルやメモリです。
方式 | 候補の作り手 | 追加で必要なもの | 向いている場面 |
|---|---|---|---|
Draft-Target | 同系列の小型LLM | 互換性のあるドラフトモデルと、そのVRAM | 手元の既存モデルの組み合わせですぐ試したい |
MTP | ターゲットに組み込まれた追加予測ヘッド | MTP対応モデル | DeepSeek系などMTP対応モデルを使う |
EAGLE系 | ターゲットの内部特徴を使う専用の軽量ドラフト | 特定ターゲット向けに学習されたEAGLE重み | 対応重みが公開されているモデルで高い効果を狙う |
N-gram | 既出のトークン列からの検索 | なし | 要約・コード修正・RAGなど、入力の言い回しを繰り返す処理 |
- Draft-Target方式
既存の小型モデルをそのままドラフトに使う、最も基本的な方式です。組み合わせの例は次のとおりです。
ターゲット | ドラフト |
|---|---|
Llama 3.1 8B Instruct | Llama 3.2 1B Instruct |
Qwen 2.5 14B Instruct | Qwen 2.5 0.5B Instruct |
ドラフトは、パラメータ数の小ささだけでなく、次の点も確認して選びます。
語彙・トークナイザーの互換性:同じトークンIDが同じ文字列を表す必要がある。同じ系列でも、世代が違うと語彙が拡張されていることがある
ドラフトの速さ:十分に速くないと、先読みの時間が節約分を食いつぶす
採択長:1サイクルで平均何トークン採択されるか。同系列で学習データの傾向が近いほど長くなりやすい
追加VRAM:ドラフトの重みとKVキャッシュの分が余分に必要
ローカル環境でよく使われるLM Studioも、この方式に対応しています。チャット画面のサイドバーでドラフトモデルを選ぶだけで有効になります。
LM Studioのドキュメントでは、ドラフトはメインモデルと同じ語彙が必要とされています。高速化を期待できるドラフトの最大サイズの目安は次のとおりです。
メインモデル | ドラフトの最大サイズの目安 |
|---|---|
7B | 1B |
14B | 3B |
32B | 7B |
※3Bのメインモデルについては、目安が示されていません。
なお、語彙が異なるモデル同士を組み合わせる拡張もあります。vLLMではuse_heterogeneous_vocabを有効にすると、両者の語彙の共通部分だけで候補を作るToken-Level Intersectionが使えます。
ただし、2026年10月時点では次の制約があります。
基本方式とは前提が異なる拡張である
draft_model方式でのみ利用できる
確率的なドラフトサンプリングには未対応
まずは同じ語彙のモデルを組み合わせましょう。そのうえで、推論エンジンとそのバージョンが対応しているかを公式ドキュメントで確認してから試すのが確実です。
- MTP方式
MTPは、1つの位置から次の複数トークンをまとめて予測するようにモデルを学習させる考え方です。もともとは学習・モデル設計の手法です。
MetaのGloeckleらの研究では、4トークン先まで予測するように学習したモデルが、自身の追加ヘッドを使った自己投機的デコーディングで最大3倍速くなりました。大きなバッチサイズでも効果があったと報告されています。
大規模モデルでの実用例がDeepSeek-V3です。テクニカルレポートの5.4.3節では、MTPモジュールを投機的デコーディングと組み合わせた結果が次のように報告されています。
2トークン目の採択率:生成トピックを問わず85~90%
生成速度:1.8倍
推論時の動きは、通常のSpeculative Decodingと同じです。MTPモジュールが候補を出し、本体が検証して確定させます。
利点:別のドラフトモデルを用意しなくてよい
制約:MTPモジュール付きで公開されたモデル系列に限られている
vLLMでの指定:"method": "mtp"。候補数は1から始めることが推奨されている
- EAGLE系
EAGLEは、ターゲットモデルの内部の特徴量を使う専用の軽量ドラフトで候補を作る方式です。
最終層付近の隠れ状態を入力にするため、ターゲットが「何を言おうとしているか」を直接使えます。トークン列だけを見る小型モデルより、採択長を伸ばしやすいのが特徴です。
後継のEAGLE-3では、主に次の点が改められました。
特徴量ではなく、トークンを直接予測する
最終層だけでなく、複数の層の特徴を組み合わせる
training-time testと呼ばれる学習方法を採用する
論文では、最大6.5倍の高速化(EAGLE-2比で約1.4倍)が報告されています。
利用者として押さえておきたいのは、方式の細部よりも次の2点です。
EAGLEのドラフト重みは特定のターゲットモデル向けに学習されたもので、ほかのモデルには流用できない
推論エンジンが、そのEAGLEのバージョン(eagle/eagle3)とターゲットの組み合わせに対応している必要がある
Hugging Faceには、RedHatAIなどが公開しているEAGLE-3の重みがあります。まずは、使いたいターゲットに対応する重みがあるか確認しましょう。
- N-gram
N-gram方式は、ニューラルネットのドラフトを使わず、すでに出てきたトークン列から候補を作る方式です。Prompt Lookup Decodingとも呼ばれます。
プロンプトや生成済みのテキストから、直近の数トークンと一致する箇所を探し、その続きを候補にします。
項目 | 内容 |
|---|---|
メリット | 追加モデルが不要で、VRAMをほとんど増やさずに試せる |
向いている処理 | 文書の要約、コードの部分修正、RAGで検索結果を引用する回答など、入力の言い回しを繰り返す処理(長い候補がそのまま採択されることがある) |
向いていない処理 | 創作や自由な対話など、入力にない内容を新しく書く処理 |
vLLMでの設定 | prompt_lookup_minとprompt_lookup_maxで、照合するn-gramの長さの範囲を指定 |
フィジカルAIに関してはこちらの記事が人気です。
Speculative Decodingが速くなる・遅くなる条件
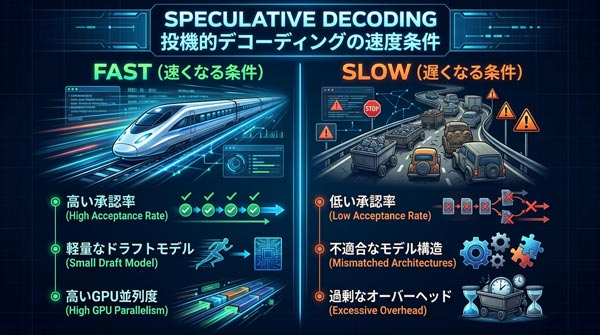
速くなるかどうかは、主に次の3つで決まります。
ドラフトの速さと採択長のバランス
GPUの負荷の高さ
メモリの余裕
このほか、文脈長(attentionの計算量)や、テンソル並列時のGPU間通信も速度に影響します。どれかが崩れると、出力は同じまま速度だけが落ちることもあります。
条件 | 01 |
ドラフトの速さと採択長のバランス
高速化の度合いは、「1サイクルで平均何トークン確定するか」と「1サイクルにかかる時間」の比で決まります。
Leviathanらの論文に沿って、各候補の条件付き採択率を一定のαとすると、1サイクルで確定するトークン数の期待値は次のとおりです。
E[確定トークン数] = (1 − α^(γ+1)) / (1 − α)
さらに次の2つを仮定すると、通常生成に対する速度向上率はおおよそ次の式で見積もれます。
ドラフト1回のforwardにかかる時間は、ターゲット1回のc倍
検証のforwardは、通常の1ステップと同じ時間
速度向上率 ≈ (1 − α^(γ+1)) / {(1 − α)(γc + 1)}
この式に数字を入れると、傾向がつかめます。
採択率α | ドラフトの相対コストc | 候補数γ | 1サイクルの期待確定数 | 速度向上率の目安 |
|---|---|---|---|---|
0.8 | 0.1 | 4 | 約3.36 | 約2.40倍 |
0.8 | 0.1 | 8 | 約4.33 | 約2.41倍 |
0.5 | 0.1 | 4 | 約1.94 | 約1.38倍 |
0.5 | 0.3 | 4 | 約1.94 | 約0.88倍(遅くなる) |
表から読み取れるポイントは、次の3つです。
採択率が高ければ、γを4から8に倍増しても伸びはほぼ頭打ち
採択率が0.5まで下がると、同じγでも効果は大きく縮む
採択率が低いうえにドラフトが重い(cが大きい)と、通常生成より遅くなる
実際には、検証のforwardもγに応じて重くなり、採択率も位置やプロンプトで変わるため、この式は目安です。
それでも、「小さく速いドラフト」と「ターゲットとよく一致するドラフト」の両立が必要だという構造はよく分かります。
LM Studioのドキュメントでも、タスクによって採択されやすさが変わると説明されています。
採択されやすい:定番の公式を答える質問や計算問題など、続きの候補が限られるタスク
棄却が増える:物語の創作など、続きが無数にあるタスク
条件 | 02 |
GPUの負荷の高さ
- 低~中負荷と高負荷ではボトルネックが変わる
効果は、同時に処理しているリクエスト数(負荷)で大きく変わります。
vLLMのドキュメントでも、主な対象は「中~低QPSで、メモリ律速のワークロード」におけるトークン間レイテンシの短縮とされています。
負荷 | GPUの状態 | Speculative Decodingの効果 |
|---|---|---|
低~中負荷 | デコードが重みの読み出しに律速され、演算器に余裕がある | 余った計算能力で候補を検証でき、ほぼ追加コストなしでステップ数を減らせる。チャットやエージェントなど、応答速度重視の用途に向く |
高負荷 | 通常のバッチ処理だけで演算器が埋まり、計算律速に近づく | 棄却される候補の検証が他のリクエストの処理を圧迫する。全体のスループットは伸びにくく、低下することもある |
vLLMのドキュメントでは、方式ごとの効果が次のように整理されています。
EAGLE・MTP:低負荷時は「効果大」、高負荷時は「中~大」
Draft-Target方式:高負荷時は「中」
N-gram・Suffix Decoding:ピーク時にも負荷を増やしにくい選択肢
負荷が時間帯で大きく変わるサービスでは、負荷に応じて投機の深さを調整するDynamic Speculative Decodingのような仕組みも検討対象になります。
条件 | 03 |
メモリの余裕
- 追加VRAMとKVキャッシュの容量を見積もる
Draft-Target方式やEAGLE系では、ターゲット本体に加えて次のメモリが必要です。
ドラフトモデル(またはEAGLEヘッド)の重み
ドラフト側のKVキャッシュ
検証中の候補γ個分の、ターゲット側の一時的なKVキャッシュ
KVキャッシュの1トークンあたりのサイズは、次の式で計算できます。
KV(バイト/トークン)= 2 × 層数 × KVヘッド数 × ヘッド次元 × 1要素のバイト数
FP16(2バイト)で計算すると、次のようになります。
モデル | 構成 | 1トークンあたり | 8,192トークンの文脈(1シーケンス) |
|---|---|---|---|
Llama 3.1 8B(ターゲット) | 32層、KVヘッド8、ヘッド次元128 | 128KiB | 約1GiB |
Llama 3.2 1B(ドラフト) | 16層、KVヘッド8、ヘッド次元64 | 32KiB | 約256MiB |
このほか、ドラフトの重みもFP16で約2.5GB増えます。
vLLMは、確保したGPUメモリからモデル重みを除いた残りをKVキャッシュに割り当てます。そのため、ドラフトを追加すると保持できるシーケンス数や文脈長が減り、同時接続数の上限が下がることがあります。
導入前に、次の合計がGPUメモリに収まるかを見積もっておきましょう。
ターゲット+ドラフトの重み
想定する同時接続数×文脈長分のKVキャッシュ
GPUSOROBANでLlamaを使う方法は、こちら記事を参考にしてみてください。
vLLMでSpeculative Decodingを導入する手順
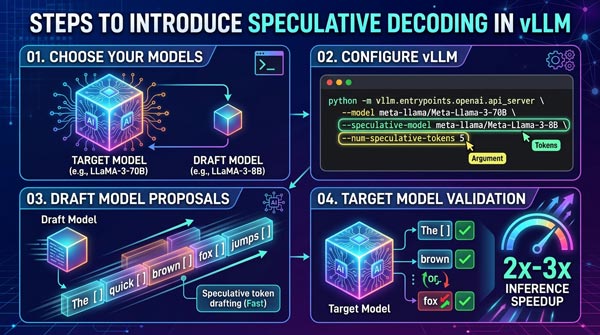
vLLMでは、speculative_config(CLIでは--speculative-config)を1つ追加するだけでSpeculative Decodingを有効にできます。
ただし、設定しただけで速くなるとは限りません。次の順に進めるのが確実です。
対応方式・モデル・実行環境を確認する
Speculative Decodingなしのベースラインを測る
speculative_configを設定して生成する
候補数と同時接続数を変えて最適値を探す
以下では、ターゲットにLlama 3.1 8B Instruct、ドラフトに同じ語彙を持つLlama 3.2 1B Instructを使う例で説明します。
手順
01
対応方式・モデル・実行環境を確認する
まず、使いたい方式が手元のvLLMのバージョンとモデルに対応しているかを確認します。2026年10月時点の公式ドキュメントには、draft_model、ngram、suffix、mtp、eagle3などの方式が掲載されています。
MTP:ターゲットがvLLMでMTPに対応したモデル系列か
EAGLE系:ターゲットに対応するEAGLE/EAGLE-3の重みが公開されているか
Draft-Target:ドラフトとターゲットの語彙・トークナイザーが一致しているか
あわせて、実行環境を記録しておきます。速度はvLLMのバージョンやGPUの種類で大きく変わるため、記録がないと測定結果を比較・再現できません。
# GPU型番・枚数・ドライバ・CUDAのバージョン
nvidia-smi
# Python/PyTorch/PyTorchが使うCUDA/vLLMのバージョン
python -c "import sys, torch, vllm; print(sys.version); print(torch.__version__, torch.version.cuda); print(vllm.__version__)"
記録しておきたい項目は、次のとおりです。
vLLM、Python、PyTorch、CUDA、ドライバのバージョン
GPUの型番・枚数
なお、vLLMのドキュメントによると、古いバージョンには次の制約があります。
vLLM 0.15.0以前:パイプライン並列とSpeculative Decodingを併用できない
vLLM 0.10.0以前:ドラフトモデル方式自体が使えない
手順
02
Speculative Decodingなしのベースラインを測る
次に、Speculative Decodingを使わない状態で同じモデルを起動し、基準となる速度を測ります。
比較対象がないと、効果があったかどうかを判断できないためです。
# ターゲット単体で起動
vllm serve meta-llama/Llama-3.1-8B-Instruct --max-model-len 8192
別のターミナルから、vLLM付属のベンチマークで負荷をかけます。
入力長・出力長・リクエスト数は、実際の用途に近い値にそろえましょう。
vllm bench serve \
--model meta-llama/Llama-3.1-8B-Instruct \
--dataset-name random \
--random-input-len 1024 \
--random-output-len 256 \
--num-prompts 200 \
--max-concurrency 1
見るべき指標は、次のとおりです。
指標 | 意味 |
|---|---|
TPOT | 出力1トークンあたりの時間 |
ITL | トークン間レイテンシ |
出力トークンのスループット | 単位時間あたりに生成できる出力トークン数 |
TTFT | 最初のトークンまでの時間 |
Speculative Decodingが主に改善するのは、TPOTとITLです。
※ランダムな入力では、実運用の採択率を再現できない場合があります。最終判断は、自社の実際のプロンプトに近いデータセットで行いましょう。
手順
03
speculative_configを設定して生成する
ベースラインが取れたら、同じ条件で--speculative-configを追加して起動し直します。
# Draft-Target方式:同じ語彙の小型モデルをドラフトに使う
vllm serve meta-llama/Llama-3.1-8B-Instruct \
--max-model-len 8192 \
--speculative-config '{
"method": "draft_model",
"model": "meta-llama/Llama-3.2-1B-Instruct",
"num_speculative_tokens": 4
}'
Pythonのオフライン推論で使う場合は、同じキーをspeculative_configに辞書で渡します。
from vllm import LLM, SamplingParams
llm = LLM(
model="meta-llama/Llama-3.1-8B-Instruct",
max_model_len=8192,
speculative_config={
"method": "draft_model",
"model": "meta-llama/Llama-3.2-1B-Instruct",
"num_speculative_tokens": 4,
},
)
params = SamplingParams(temperature=0.0, max_tokens=256)
outputs = llm.generate(["Speculative Decodingを一文で説明してください。"], params)
print(outputs[0].outputs[0].text)
ほかの方式に切り替える場合は、speculative_configの中身だけを変えます。
# EAGLE-3:ターゲット専用に学習されたEAGLE-3の重みを指定
--speculative-config '{"method": "eagle3", "model": "RedHatAI/Llama-3.1-8B-Instruct-speculator.eagle3", "num_speculative_tokens": 2}'
# N-gram:追加モデルなし。照合するn-gramの長さを指定
--speculative-config '{"method": "ngram", "num_speculative_tokens": 4, "prompt_lookup_min": 2, "prompt_lookup_max": 5}'
# MTP:MTP対応モデルのみ。候補数は1から始める
--speculative-config '{"method": "mtp", "num_speculative_tokens": 1}'
設定時の注意点は、次のとおりです。
ドラフトのテンソル並列数は、tensor_parallel_sizeではなくdraft_tensor_parallel_sizeで指定する
temperatureやtop_pはサンプリングパラメータなので、speculative_configには書かない
起動ログのSpeculativeConfig(method=...)で、意図した方式が選ばれているか確認する
起動できたら、まずtemperature=0で同じプロンプトを投げ、ベースラインと出力を比べます。
vLLMはgreedyでの出力一致をテストで検証していますが、浮動小数点の誤差やバッチサイズの違いで、まれに差が出ることがあります。
手順
04
候補数と同時接続数を変えて最適値を探す
最後に、候補数(num_speculative_tokens)と同時接続数を変えながら、同じベンチマークを繰り返します。検証用の値の例は次のとおりです。
候補数:2・4・6
同時接続数(--max-concurrency):1・4・16
※用途に合わせて範囲を調整してください。
候補数を1つ固定してサーバーを起動し、同時接続数だけを変えてベンチマークを回します。これを候補数ごとに繰り返します。
# サーバーを num_speculative_tokens=2 で起動した状態で実行
for c in 1 4 16; do
vllm bench serve \
--model meta-llama/Llama-3.1-8B-Instruct \
--dataset-name random \
--random-input-len 1024 \
--random-output-len 256 \
--num-prompts 200 \
--max-concurrency "$c"
done
計測時は、次の点にも注意しましょう。
--max-concurrencyは同時実行数の上限で、リクエストの到着ペースは指定しない
--request-rateの既定値はinf(全リクエストを最初に一斉送信)。一定のQPSで測りたい場合は、--request-rateも指定する
起動直後の計測値はぶれやすいため、--num-warmupsでウォームアップを入れ、同じ条件を複数回計測して比較する
結果は次のような表にまとめると、ベースラインと比較しやすくなります。
候補数 | 同時接続数 | TPOT(ms) | 出力スループット(tok/s) | 平均採択長 | ベースライン比 |
|---|---|---|---|---|---|
なし | 1 | 記入欄 | 記入欄 | — | 1.00 |
2 | 1 | 記入欄 | 記入欄 | 記入欄 | 記入欄 |
4 | 1 | 記入欄 | 記入欄 | 記入欄 | 記入欄 |
6 | 1 | 記入欄 | 記入欄 | 記入欄 | 記入欄 |
採否はTPOTだけで決めず、次の項目もあわせて確認し、自社の要件に照らして判断しましょう。
TTFT:最初のトークンまでの時間が悪化していないか
出力スループット:同時接続数を増やしたときに下がっていないか
GPUメモリ使用量:ドラフトの追加で、同時接続数や文脈長の上限が下がっていないか
平均採択長や採択率は、サーバーのログや/metricsで確認できます。
リクエスト単位で確認したい場合は、対応するバージョンのvLLMで、起動時に--per-request-spec-decode-metrics summary(またはdetailed)を指定します。レスポンスに平均採択長などが含まれるようになります。
※Per-Request Acceptance Metricsは、2026年10月時点では実験的な機能で、既定値はnoneです。
一般的な傾向は、次のとおりです。
同時接続数が少ないほど、候補数を増やす余地がある
同時接続数が増えるほど、小さい候補数やSpeculative Decodingなしの方が有利になりやすい
この切り替わりが自分の環境のどこで起きるかを見つけることが、チューニングのゴールです。
Speculative Decodingを試すGPU環境の選び方
Speculative Decodingを試すGPUは、次の2点を軸に選びます。
ターゲット+ドラフト+KVキャッシュが余裕をもって載るVRAM
デコード速度を左右するメモリ帯域
演算性能(FLOPS)よりも、この2点が効果を左右しやすいのがこの手法の特徴です。
選び方 | 01 |
VRAM:ターゲットとドラフトの重み+KVキャッシュで見積もる
FP16/BF16の重みは、おおよそ「パラメータ数×2バイト」です。
8Bモデル:約16GB
70Bモデル:約140GB
ここに、ドラフトの重み、両モデルのKVキャッシュ、vLLMの作業領域が加わります。
ターゲット単体でVRAMがぎりぎりだと、ドラフトを追加した途端に同時接続数や文脈長を削ることになり、比較の条件がそろいません。
選び方 | 02 |
メモリ帯域:デコードの速さを決める
低負荷時のデコードはメモリ帯域に律速されるため、帯域が広いGPUほど、通常生成そのものは速くなる傾向があります。
ただし、Speculative Decodingによる相対的な高速化率は、帯域だけでは決まりません。採択率、ドラフトの速さ、演算性能とのバランス、バッチサイズなどで変わります。
GPU | GPUメモリ帯域 | メモリ容量 |
|---|---|---|
NVIDIA H100(SXM) | 3.35TB/s | 80GB |
NVIDIA H200(SXM) | 4.8TB/s | 141GB |
70BクラスのモデルをFP16/BF16で扱う場合、重みだけで約140GBになります。H200でも1枚ではドラフトやKVキャッシュを置く余裕がほとんどないため、次のどちらかが必要です。
テンソル並列で複数GPUに分割する
FP8などに量子化する
選び方 | 03 |
GPU枚数と接続:テンソル並列で分割するか
1枚に載らないモデルは、テンソル並列で複数GPUに分割します。
検証のforwardのたびにGPU間通信が発生するため、NVLinkなど高速な接続を持つ構成が有利
ドラフトは小さいので、draft_tensor_parallel_sizeで別の並列数を指定でき
選び方 | 04 |
ソフトウェア環境:CUDAとドライバのバージョン
Speculative Decodingの対応方式は、vLLMのバージョンで大きく変わります。新しいvLLMを使うには、対応したPyTorch・CUDA・ドライバが必要です。
手元のマシンでドライバを更新できない場合や、OSごと環境を作り直したい場合は、クラウドの方が試しやすいことがあります。
モデル規模ごとのGPU構成の目安は、次のとおりです。
ターゲットの規模(FP16/BF16) | 重みの目安 | 検証に向くGPU構成の例 | 主な注意点 |
|---|---|---|---|
7~8Bクラス | 約14~16GB | VRAM 24GB以上のGPU1枚 | ドラフト+KVキャッシュの余裕を確保する |
14~32Bクラス | 約28~64GB | VRAM 80GBクラスのGPU1枚 | 32Bは量子化やテンソル並列も検討 |
70Bクラス | 約140GB | H200×2枚、H100 80GB×2枚以上など(量子化する場合は単一GPUも検討可能) | GPU間の接続帯域と同時接続数の上限 |
数百B級(MoEを含む) | 数百GB以上 | 8枚構成のGPUサーバー | MTP対応モデルならドラフト不要で試せる |
GPU環境を比べるときは、1時間あたりのGPU単価だけで判断しないことも大切です。同じモデル・設定でも、GPUの種類や枚数で出力スループットは変わります。
測定したスループットから、次のような処理量あたりの費用に換算して比べると、費用対効果を判断しやすくなります。
100万トークン生成あたりの費用
想定するリクエスト量を処理するための費用
Speculative Decodingの検証は、何度も起動し直して測る作業です。そのため、必要なときに必要な時間だけ使えるGPUクラウドと相性が良いといえます。
たとえば国内のGPUクラウドサービスGPUSOROBANでは、NVIDIA H200やB200を搭載した環境が提供されています。B200のクラスター環境は、GPU1枚・1分単位の課金で利用できます。
まず小さな構成で効果を確かめ、本番に必要なGPU枚数を見極めてから拡張する、という進め方も取りやすくなります。
Speculative Decodingに相性が良い高性能GPU・B200については、こちらの記事を参考にしてみてください。
Speculative Decodingのまとめ

Speculative Decodingは、ドラフトが先読みした候補をターゲットモデルがまとめて検証し、ターゲットの出力分布を保ったまま生成を速くする手法です。
目的:ターゲットの逐次ステップ数を減らす。量子化やKVキャッシュとは目的が異なり、多くの場合は併用できる
精度が変わらない根拠:採択確率min(1, p(x)/q(x))と、棄却時にmax(p−q, 0)を正規化した分布から引き直す規則
主な方式:Draft-Target・MTP・EAGLE系・N-gramなど。使えるモデルや追加メモリが異なる
速くなる条件:採択率とドラフトの軽さのバランス、負荷の高さ、VRAMの余裕で決まる。低~中負荷で効果が出やすい
導入:vLLMではspeculative_configで有効化。ベースラインを測り、候補数と同時接続数を変えて最適値を探す
効果は環境とワークロードによって大きく変わります。まずは自社のプロンプトに近いデータで、ベースラインとの比較から始めてみてください。