なぜ長文LLMは遅くなるのか|Decode Context ParallelismでKVキャッシュを分散する
数万トークンのコードベースや長い会話履歴をまるごと渡す「長文LLM」の利用が当たり前になった一方で、コンテキストが長くなるほど応答が遅くなってしまいます。
その遅さの正体はひとつではなく、プロンプトを読み込むPrefillと、トークンを生成するDecodeとでは、そもそもボトルネックの性質が違ってきます。
この記事では、GQAやMLAを採用した近年のモデルでTensor ParallelismがなぜKVキャッシュを重複させてしまうのかを整理したうえで、vLLMが実装するDecode Context Parallelism(DCP)がその重複をどう解消するのか、仕組みから具体的な設定例、導入判断の基準まで解説します。
NVIDIA H200を搭載したGPUを、クラウドで手軽に使える!
最先端のNVIDIA H200を、クラウドでご提供。学習・推論のスピードはそのままに、GPUコストの見直しにもご活用いただけます。生成AI・LLM学習・シミュレーションなど大規模計算に最適。GPUを自社で購入・設置することなく、最新GPUを手軽に利用できます。
目次[非表示]
- 1.長文LLMとは?
- 2.長文LLMはなぜ遅くなるのか|3つのボトルネック
- 2.1.Prefillでは入力トークンが増えるほどAttention計算が重くなる
- 2.2.KVキャッシュがコンテキスト長と同時実行数に応じて膨らむ
- 2.3.Decodeでは毎トークン過去のKVを読み出すためメモリ帯域が効く
- 3.KVキャッシュが長文LLMのDecodeを圧迫する仕組み
- 3.1.KVキャッシュは過去トークンのKey/Valueを保存し再計算を避ける
- 3.2.Tensor ParallelismはKV head単位でしかKVキャッシュを分割できない
- 3.3.GQA・MLAではGPU間にKVキャッシュの重複が生じやすい
- 4.Decode Context Parallelism(DCP)とは
- 4.1.KVキャッシュをシーケンス方向に分割して各GPUが一部だけ保持する
- 4.2.DecodeはQueryの共有→Local Attention→結果統合で進める
- 4.3.vLLMのDCPは既存TP rankを再利用してKVキャッシュの保持方法を変える
- 5.DCPが効きやすい長文LLMの条件
- 5.1.ワークロード軸
- 5.2.モデル軸
- 5.3.GPU間通信軸
- 5.4.DCPの効果を確認するためのベンチマーク指標
- 6.DCP以外の長文LLM最適化と使い分け
- 7.長文LLMを検証するGPU環境はVRAMだけでなくGPU間通信も確認する
- 8.まとめ|「割れないKVキャッシュ」を割る発想が長文LLMを変える
長文LLMとは?
この記事では、数万トークン以上の長いコンテキストを扱うLLMや、その利用形態を長文LLMと呼びます。
コードベース全体を読み込ませて質問に答えさせるコーディングエージェントや、長いチャット履歴を保持し続けるマルチターンのエージェント型タスクでは、コンテキスト長そのものが実用上のスペックとして重視されるようになっています。
PrefillとDecodeでは長文で遅くなる理由が異なる
LLMの推論は大きく2段階に分かれます。
項目 | Prefill | Decode |
|---|---|---|
処理内容 | 入力プロンプトのトークン列をまとめて並列処理し、各層でKey/ValueをKVキャッシュとして作る | 1トークンずつ自己回帰的に生成しながら、保存済みのKVキャッシュを参照する |
長文で重くなる理由 | 入力長が伸びるほどAttention計算量が増える | 参照するKVキャッシュの量が文脈長に比例して増える |
ボトルネックの性質 | 計算律速寄り | メモリ帯域律速寄り(1ステップの計算量自体は小さい) |
この2つは計算特性がまったく異なるため、「長文だと遅くなる理由」もPrefillとDecodeでは別物になります。
推論速度を評価する指標も、フェーズごとに見るものが異なります。
指標 | 意味 | 主に反映するもの |
|---|---|---|
TTFT | リクエストから最初のトークンが返るまでの時間 | Prefillの重さ |
TPOT | 2トークン目以降の1トークンあたりの平均生成時間 | Decodeの速さ |
ITL | 連続するトークンの出力間隔 | Decodeの速さ |
スループット | 単位時間あたりに処理できるトークン数やリクエスト数 | 同時実行数を増やしたときのシステム全体の処理量 |
LLMをクラウドで動かす方法はこちらの記事で紹介しています。
長文LLMはなぜ遅くなるのか|3つのボトルネック
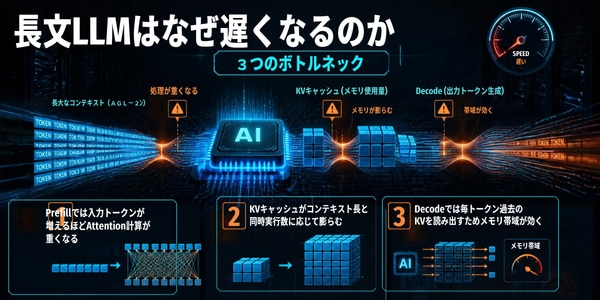
長文で遅くなる原因を分解すると、大きく以下の3つのボトルネックに整理できます。
- Prefillでは入力トークンが増えるほどAttention計算が重くなる
- KVキャッシュがコンテキスト長と同時実行数に応じて膨らむ
- Decodeでは毎トークン過去のKVを読み出すためメモリ帯域が効く
ボトルネック | 01 |
Prefillでは入力トークンが増えるほどAttention計算が重くなる
標準的なfull attentionでは、シーケンス長Tのトークン列に対してAttentionスコア行列がT×Tのオーダーで発生するため、計算量はTの2乗に比例して増加します。
FlashAttentionのようなカーネルはこの計算量そのものを減らすわけではなく、Attention計算をタイル分割してGPUの高速なメモリ上で処理することで、低速なHBMへのメモリアクセスを最小化する技術です。これによりメモリ効率と実行速度は大幅に改善しますが、シーケンス長が伸びるほどPrefillの絶対的な計算負荷が増えるという構造自体は変わりません。
長い入力を渡したときにユーザーが体感する「レスポンスが遅い」には、このPrefillフェーズの計算時間が大きく関わっている場合があります。コードベース全体を貼り付けるようなエージェント用途では、生成が始まる前にこのPrefillを終える必要があるため、TTFTが数秒〜数十秒に及ぶこともあります。
ボトルネック | 02 |
KVキャッシュがコンテキスト長と同時実行数に応じて膨らむ
Prefillの段階で計算されたKey/Valueは、Decode時に再計算しないよう、GPUメモリ上にKVキャッシュとして保持されます。このキャッシュサイズ(バイト数)は、おおまかに次の要素を掛け合わせて見積もれます。
- レイヤー数
- KVヘッド数
- head_dim
- 2(KとVの分)
- データ型のバイト数(BF16/FP16は2バイト、FP8は1バイト)
- コンテキスト長
- 同時に処理するリクエスト数
この式はKVヘッドごとにKey/Valueを保持するMHAやGQAを前提としたものです。MLAはKey/Valueを圧縮した潜在ベクトルとしてキャッシュするため構造が異なり、この式をそのまま当てはめることはできません。
重要なのは、これが1リクエストの長さだけでなく、同時に捌くリクエスト数にも比例して膨張する点です。GPUメモリは有限なので、KVキャッシュが肥大化するほど同時に処理できるリクエスト数の上限が下がり、結果としてスループットが頭打ちになってしまいます。
ボトルネック | 03 |
Decodeでは毎トークン過去のKVを読み出すためメモリ帯域が効く
Decodeフェーズは1ステップごとに1トークン分のQueryしか計算しないため、演算量自体は小さいです。しかしAttentionの計算では、そのQueryを過去の全トークンのKey/Valueに対して照合する必要があるため、コンテキストが長くなるほど1ステップあたりに読み出すKVキャッシュの量が増えていきます。
GPUの演算性能に対してメモリ帯域は相対的に伸びが遅いため、Decodeは「計算待ち」よりも「メモリからの読み出し待ち」がボトルネックになりやすい特徴があります。
これはTPOT、あるいはITLという指標に影響します。
TPOTは1トークンを出力するのにかかる平均時間で、ストリーミング表示のなめらかさを左右します。短いコンテキストでは軽快だったモデルが、コンテキストが数万トークンを超えたあたりから急にトークン生成がぎこちなくなる場合、その原因の多くはこのKVキャッシュ読み出し量の増大にあることが分かります。
AI開発の本番運用に必要なクラウドインフラの考え方に関しては、こちらの記事で詳しく解説しています。
KVキャッシュが長文LLMのDecodeを圧迫する仕組み
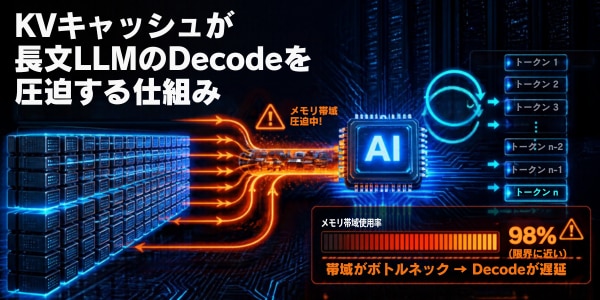
前章で見たボトルネックをさらに掘り下げると、その正体はKVキャッシュそのものの持ち方にあります。
KVキャッシュがなぜ必要なのか、複数GPUに分散させるTensor Parallelismがなぜこれを完全には解決できないのか、そして近年主流のGQA・MLAというアーキテクチャがこの問題をどう複雑にしているのかを順番に見ていきます。
STEP
01
KVキャッシュは過去トークンのKey/Valueを保存し再計算を避ける
Transformerの各層では、入力トークンに対しQuery/Key/Valueの3種類のベクトルを計算します。Decode時、生成済みトークンのKey/Valueを毎回再計算していては非効率なため、一度計算したKey/ValueをKVキャッシュとしてGPUメモリに保持し、新しいトークン分のKVだけを追加していきます。
KVキャッシュを使うことで、Decodeの処理は次のように変わります。
- 新たに計算するKey/Value:新規1トークン分だけで済みます。
- 省略できる処理:過去トークンのKey/Valueの再計算です。
- 毎ステップ必要な処理:新しいトークンのQueryを過去の全トークンのKey/Valueと照合するAttention演算です。
- 代償:KVキャッシュというメモリリソースを消費し続けます。
STEP
02
Tensor ParallelismはKV head単位でしかKVキャッシュを分割できない
複数GPUにモデルを分散させるTensor Parallelismでは、Attentionの各ヘッドをGPU間で分割して保持するのが基本的な考え方です。これはKVキャッシュにも当てはまり、KVヘッドをGPUごとに割り当てることで、1GPUあたりのKVキャッシュ量をヘッド数分の1に減らせます。
この分割には限界があります。KVヘッドは「これ以上細かく割れない最小単位」であるため、TPの並列度がKVヘッド数を超えると、割り当てるヘッドが足りなくなってしまいます。その結果、複数のGPUが同じKVヘッドのキャッシュを重複して保持することになり、TP並列度をそれ以上上げてもKVキャッシュのメモリ消費量は減らなくなるのです。
STEP
03
GQA・MLAではGPU間にKVキャッシュの重複が生じやすい
この制約は、近年主流になっているGQAやMLAを採用したモデルでより顕著に現れます。
GQAはQueryヘッド数に対してKVヘッド数を意図的に減らすことで、そもそものKVキャッシュ量とメモリ帯域消費を抑える設計です。しかしKVヘッド数が少ないということは、TPで分割できる単位も少ないということです。
TP並列度とKVヘッド数の関係によって、KVキャッシュの重複は次のように変わります。
構成 | KVキャッシュの扱い | 重複の倍率 |
|---|---|---|
TP並列度 ≦ KVヘッド数 | KVヘッドをGPU間で分割 | 重複なし |
TP並列度 > KVヘッド数(GQA、TP並列度がKVヘッド数で割り切れる構成) | 各KVヘッドを複数GPUに複製 | TP並列度 ÷ KVヘッド数 |
MLA(vLLMでは実質KVヘッド数1) | 潜在KVキャッシュを全TPランクに複製 | TP並列度と同じ(TP8なら8倍) |
MLAは、Key/Valueを低ランクの潜在ベクトルに圧縮してキャッシュする設計です。vLLMはDecode時にこの潜在ベクトルを全Queryヘッドで共有する形で扱うため、KVキャッシュの分割においては実質1つのKVヘッドとして扱われます。そのため、vLLMでMLAモデルをTPで動かすと、分割対象のヘッドが1つしかないKVキャッシュがTPランク数と同じ数だけ重複して保持されます。DeepSeek-V2/V3/R1やKimi K2系のMLA採用モデルをvLLMのTP8で動かせば、同じ潜在KVキャッシュが8基のGPUすべてに複製されることになります。
この重複したKVキャッシュがGPUメモリを圧迫し、結果として同時に処理できるリクエスト数の天井を押し下げます。これが、Decodeフェーズにおける長文処理を非効率にする核心的な仕組みです。
Decode Context Parallelism(DCP)とは
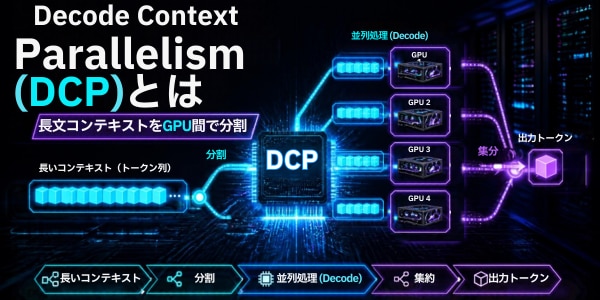
前段の課題、すなわち「TPはヘッド単位でしかKVキャッシュを分割できず、GQAやMLAでは重複が避けられない」という問題への答えが、Decode Context Parallelism(DCP)です。
KVキャッシュをシーケンス方向に分割して各GPUが一部だけ保持する
DCPは、TPのようにヘッド方向でKVキャッシュを割るのではなく、シーケンス方向で分割します。同じリクエストのKVキャッシュをトークン単位でGPUごとに振り分け、各GPUは自分に割り当てられたトークンのKVだけを保持します。
vLLMの実装では、この振り分けをインターリーブ(交互配置)方式で行います。インターリーブサイズが1の場合、トークンiのKVは「i mod DCPサイズ」番目のGPUに置かれます。DCPサイズ4なら、各GPUが保持するトークンは次のとおりです。
GPU | 保持するトークン(インターリーブサイズ1の場合) |
|---|---|
GPU0 | 0、4、8、12… |
GPU1 | 1、5、9、13… |
GPU2 | 2、6、10、14… |
GPU3 | 3、7、11、15… |
- 何トークンずつまとめて振り分けるかは
--cp-kv-cache-interleave-sizeで変更できます。 - Decodeで新しく生成されたトークンも同じ規則で振り分けられるため、生成が進んでもKVキャッシュはGPU間に分散された状態を保てます。
例えば20万トークンのリクエストをDCPサイズ4で処理する場合、各GPUはそれぞれ約5万トークン相当のKVキャッシュを分担して保持します。ただし、GPU0がトークン0〜5万、GPU1が5万〜10万を担当するような連続範囲への固定割り当てではなく、トークンを順番に各GPUへ振り分けた結果として約5万トークンずつになる点に注意してください。
DCPの効果と注意点は次のとおりです。
- 効果:TPでは既存のTPランク間で重複していたKVキャッシュを分担して持てるようになり、重複を減らした分だけ各GPUのKVキャッシュ領域により多くのトークンを載せられます。
- GPUは増えない:DCPは追加のGPUを使う仕組みではなく、既存のTPランクの役割を組み替えるものです。
- 比例して改善するわけではない:DCPサイズを大きくするほど通信も増えるため、速度やメモリの余裕がDCPサイズに比例して改善するわけではありません。
DecodeはQueryの共有→Local Attention→結果統合で進める
DCPが有効な状態でのDecode1ステップは、次の3段階で進めます。
- Queryの共有(AllGather Q):Decode中は1トークン分のQueryしか計算されないため、通信量は小さく抑えられます。代表的な実装では、各GPUが持つQueryの断片(ヘッド方向に分かれた部分)をAllGather通信で集約し、DCPグループ内の全GPUが同じQueryを持つ状態にします。
- Local Attention:各GPUは、集約されたQueryと自分が担当するトークンのKVキャッシュだけを使ってAttentionを計算します。
- AllGather + ReduceScatter:オンラインSoftmaxで使うLSE値をAllGatherで共有し、各GPUの部分的な出力を正しい重みで補正したうえで、ReduceScatterによって合算した最終出力を各GPUに配布します。
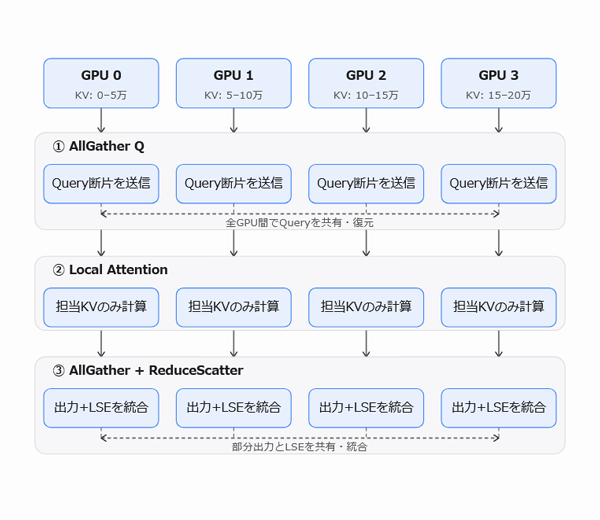
この通信パターンは、Decode特有の「1ステップあたりのQueryが小さい」という性質を利用しており、通信コストを抑えつつシーケンス方向の分割を実現しています。
上記は、vLLMの既定の通信バックエンドであるag_rsを代表例とした流れです。vLLMでは、通信方式を次のように選べます(いずれもvLLM v0.31.0で確認)。
方式・オプション | 内容 | 指定方法 |
|---|---|---|
ag_rs(既定) | LSE値をAllGatherで共有し、補正した部分出力をReduceScatterで合算・配布する |
|
a2a | 各GPUの部分出力とLSE値をAll-to-All通信で交換してから統合する |
|
Queryの複製 | MLAモデルでQueryの射影を各GPUで重複して計算し、QueryのAllGatherを省略する |
|
なお、モデルによっては既定値がa2aに設定されています。
vLLMのDCPは既存TP rankを再利用してKVキャッシュの保持方法を変える
vLLMにおけるDCPの導入はシンプルで、GPU台数を追加する必要はありません。既存のTP構成の上に--decode-context-parallel-sizeを追加するだけで、同じGPU群の役割を「ヘッド分割担当」から「シーケンス分割担当」へ組み替えます。
以下のコードは、vLLMのPython APIを使ってDeepSeek-V4-Flashをオフラインで動かす例です。
ただし、DCPを使った実行条件は、次の要素によって異なります。
- 対象のvLLMバージョン
- モデルとの互換性
- GPUメモリの容量
- 利用できるAttentionバックエンド(DCPにはDecode時にSoftmaxのLSE値を返せるバックエンドが必要で、対応していないバックエンドでは起動時にエラーになります)
以下のコードは設定方法を示すための記述例で、本記事では実機での動作を確認していないため、この構成での動作を保証するものではありません。実行前に、利用するvLLMのバージョンでモデルとAttentionバックエンドの対応状況を公式ドキュメントとリリースノートで確認してください。
# オフライン推論(Python API)
from vllm import LLM, SamplingParams
llm = LLM(
model="deepseek-ai/DeepSeek-V4-Flash",
tensor_parallel_size=2,
decode_context_parallel_size=2,
)
outputs = llm.generate(
["The future of AI is"],
SamplingParams(temperature=0.8, top_p=0.95),
)
for output in outputs:
print(output.outputs[0].text)
# オンライン推論(サーバー起動)
vllm serve deepseek-ai/DeepSeek-V4-Flash \
--tensor-parallel-size 2 \
--decode-context-parallel-size 2
MLA系モデルとGQA系モデルではDCPサイズの上限計算が異なるので注意しましょう。
モデル | DCPサイズの上限 | 例 |
|---|---|---|
MLA(実質KVヘッド数1) | TP並列度と同じ値 | DeepSeek-R1をTP並列度8で動かす場合、最大8 |
GQA | TP並列度 ÷ KVヘッド数 | Qwen3-235B-A22B(KVヘッド数4)をTP並列度8で動かす場合、最大2 |
vLLMではMLAを実質KVヘッド数1として扱うため、TP並列度と同じ値までDCPサイズを設定できます。
# DeepSeek-R1(MLA、実質KVヘッド数=1)
vllm serve deepseek-ai/DeepSeek-R1 \
--tensor-parallel-size 8 \
--decode-context-parallel-size 8
GQAはKVヘッド数の分だけTPで分割できてしまうため、DCPサイズの上限は「TP並列度 ÷ KVヘッド数」で頭打ちになります。
# Qwen3-235B-A22B(GQA、KVヘッド数=4)
# tp=8なら重複度は8/4=2なので、dcpは最大2まで
vllm serve Qwen/Qwen3-235B-A22B \
--tensor-parallel-size 8 \
--decode-context-parallel-size 2
ポイント:decode_context_parallel_sizeは「GPUを追加確保するオプション」ではなく、あくまで既存TPランクの中でKVキャッシュ重複の持ち方を再配置するオプションである点に注意しましょう。
DCPサイズの設定には制約があります。vLLM v0.31.0(2026年10月時点の最新リリース)のソースコード(vllm/config/parallel.py、vllm/config/model.py)では、起動時に次の条件を確認しています。
tensor_parallel_size(TP並列度)がdecode_context_parallel_size(DCPサイズ)で割り切れること(全モデル共通)- GQA/MQAモデルでは、TP並列度がモデルのKVヘッド数より大きいこと(TP並列度 > KVヘッド数)
- GQA/MQAモデルでは、DCPサイズが「TP並列度 ÷ KVヘッド数」(小数点以下切り捨て)以下であること
- GQA/MQAモデルでは、「Queryヘッド数 ÷ KVヘッド数」がDCPサイズで割り切れること
例えば上記のQwen3-235B-A22B(Queryヘッド数64、KVヘッド数4)をTP並列度8・DCPサイズ2で動かす場合は、次のとおりすべての条件を満たします。
- 8 ÷ 2 = 4で、TP並列度がDCPサイズで割り切れる
- TP並列度8はKVヘッド数4より大きい
- DCPサイズの上限は8 ÷ 4 = 2で、DCPサイズ2は上限以下
- 64 ÷ 4 = 16は2で割り切れる
条件はバージョンによって変わる可能性があるため、導入時は利用するvLLMのバージョンの実装とドキュメントで、TP並列度とDCPサイズの組み合わせが整合しているかを確認してください。
DCPが効きやすい長文LLMの条件
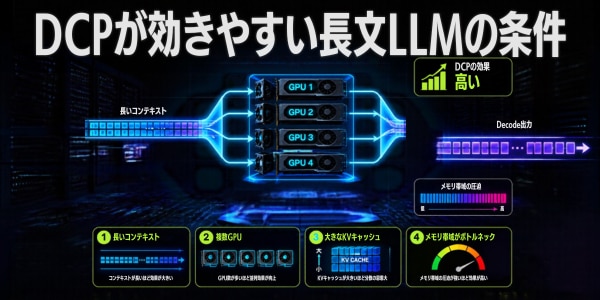
DCPは万能薬ではなく、効果が出やすい条件とそうでない条件があります。
導入判断は主に次の3つの軸で行うとよいでしょう。
軸 | DCPが効きやすい | DCPの効果が小さい |
|---|---|---|
ワークロード | 長い入力に対して比較的短い出力を、大量の同時リクエストで処理する | 長い入力を数本ずつ処理する、短い入力が中心 |
モデル | MLAモデル、KVヘッド数が少ないGQAモデル | KVヘッド数が多いGQAモデル、MHAモデル |
GPU間通信 | NVLinkなど高帯域なノード内接続でDCPを構成する | 低帯域なノード間ネットワーク越しにDCPサイズを大きく取る |
それぞれの軸の詳細は以下のとおりです。
条件 | 01 |
ワークロード軸
DCPが効きやすいのは、長い入力に対して比較的短い出力を、大量の同時リクエストで捌く「エージェント的」なワークロードです。
長い入力を数本だけ順番に処理するような使い方や、短い入力しか扱わないワークロードでは、KVキャッシュがボトルネックになりにくく、DCP導入の恩恵は小さくなります。
条件 | 02 |
モデル軸
KVヘッド数が多いGQAモデルや、そもそもKVヘッド数がQueryヘッド数と同数のMHAモデルでは、TP段階でのKVキャッシュ重複が起きにくく、DCPの効果は限定的になります。
逆にMLAモデルや、KVヘッド数が少ないGQAモデルほど、TPだけでは解消できない重複が大きく残るため、DCPの効果が大きくなります。
条件 | 03 |
GPU間通信軸
DCPはDecodeの毎ステップでAllGatherとReduceScatterという集団通信を挟むため、GPU間の通信帯域がボトルネックになりやすい傾向にあります。
NVLinkのような高帯域なノード内インターコネクトを持つ環境では通信オーバーヘッドが計算とのオーバーラップで隠れやすいですが、ノードをまたいだ低帯域なネットワーク越しにDCPサイズを大きく取ると、通信待ちが支配的になり、KVキャッシュを分散した効果が相殺されかねません。
DCPの効果を確認するためのベンチマーク指標
DCPの効果は、設定を有効にしただけでは判断できません。導入前後で次の条件と指標を比較し、対象のワークロードで効果が出ているかを確認しましょう。
- 比較条件:TP並列度は固定したまま、DCPサイズ1(DCPなし)とDCPを有効にした構成を比較します。TP並列度も同時に変えると、DCPによる変化とTPによる変化を区別できなくなります。
- 入出力長・同時実行数:入力長・出力長と同時実行数をそろえて測定します。DCPの効果は入力が長く同時実行数が多いほど表れやすいため、実際のワークロードに近い組み合わせを複数用意して比較します。
- TTFT:最初のトークンが返るまでの時間です。DCPは主にDecode向けの手法のため、TTFTが悪化していないかを確認する目的で見ます。
- TPOT:1トークンあたりの生成時間です。DCPで増える通信がDecodeの速度にどの程度影響しているかを確認します。
- スループット:単位時間あたりの出力トークン数や処理リクエスト数です。KVキャッシュの重複が減り、同時に処理できるリクエストが増えた効果は主にこの指標に表れます。
- KVキャッシュ使用量:vLLMの起動ログに表示されるKVキャッシュの容量(「GPU KV cache size: ○○ tokens」)や、メトリクスのKVキャッシュ使用率(vllm:kv_cache_usage_perc)を比較し、重複が減った分だけ保持できるトークン数が増えているかを確認します。
- 通信負荷:DCPサイズを上げたときにTPOTが悪化していないか、DCPの通信がノード内に収まる構成になっているかを確認します。
TTFT・TPOT・ITL・スループットは、vLLMに付属するベンチマークコマンド(vllm bench serve)でまとめて計測できます。
AIのつくり方に関しては、こちらの記事で基本から解説しています。
DCP以外の長文LLM最適化と使い分け
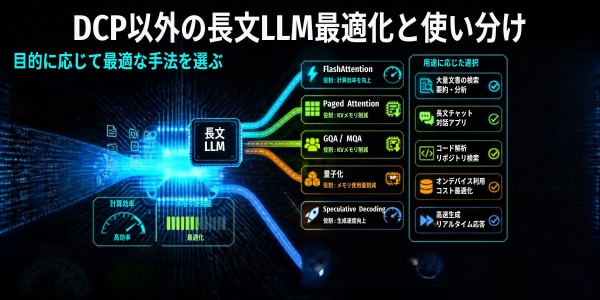
DCPはあくまでDecodeフェーズのKVキャッシュ重複という特定の課題に効く手法であり、長文LLM最適化の全てを解決するわけではありません。
課題の所在によって使い分けるべき手法をまとめると、次のようになります。
課題 | 有効な手法 | 主に効くフェーズ |
|---|---|---|
Prefillの計算時間が長くTTFTが悪化する | PCP、chunked prefill、FlashAttention等のattention実装最適化 | Prefill |
KVキャッシュが大きくGPUメモリを圧迫 | DCP、KVキャッシュの量子化 | Decode |
同じプレフィックスを繰り返し処理している | Prefix Caching | Prefill |
入力トークン数が過多 | RAGによる関連情報の絞り込み、context trimming・要約 | 入力設計段階 |
表で同じ行に並ぶDCPとKVキャッシュの量子化は役割が異なり、DCPはTPランク間で重複していたKVキャッシュを複数GPUに分担させて重複を減らす手法、KVキャッシュの量子化はFP8などの低精度データ型で保存して1トークンあたりのKVキャッシュのサイズ自体を小さくする手法です。
長文LLMが遅いと感じたときは、まず「Prefillが遅いのか、Decodeが遅いのか、それとも同時実行数を上げた途端に遅くなるのか」を切り分けます。
症状 | 主な原因 | 検討する最適化 |
|---|---|---|
TTFTが長い(最初の応答が遅い) | Prefill | Prefill側の最適化 |
TPOTが長い(生成が遅い) | Decode | Decode側の最適化 |
同時実行数を上げるとスループットが頭打ちになる | Decode(KVキャッシュによるメモリ圧迫) | Decode側の最適化 |
AI開発に適したプログラミング言語に関しては、こちらの記事から確認ができます。
長文LLMを検証するGPU環境はVRAMだけでなくGPU間通信も確認する
長文LLMの推論基盤を検証する際、VRAM容量にばかり目が向きがちですが、DCPのような分散KVキャッシュの手法を活かすには、GPU間の通信帯域も同様に重要な検証項目になります。
検証環境では、次の項目を確認しておきましょう。
確認項目 | 内容 |
|---|---|
ノード内のGPU間接続 | NVLink/NVSwitchを備えた構成では、ノード間ネットワークより高帯域なGPU間接続を利用できます。実際の帯域はGPUの世代やサーバー構成によって異なります。 |
ノード間のネットワーク | InfiniBandやRoCEなどのネットワーク帯域が実質的な上限になり、DCPのAllGather・ReduceScatter通信がここで律速される可能性があります。 |
検証コスト | GPUの種類と枚数、利用する事業者、課金方式、料金の改定時期によって大きく変わります。利用予定の構成で最新の料金表を確認しておきましょう。 |
長時間のベンチマークをいきなり回すのではなく、次の順で段階的に進めると、コスト面でも安全です。
- 小さい同時実行数・短いコンテキスト長で、TP/DCPの設定が正しく起動することを確認する
- 同時実行数とコンテキスト長を段階的に引き上げる
- 各段階でKVキャッシュ使用率とスループットを計測する
GPUクラウドに関する詳しい仕組みに関しては、こちらの記事を参考にしてみてください。
まとめ|「割れないKVキャッシュ」を割る発想が長文LLMを変える
記事のポイントをまとめます。
- 長文LLMが遅くなる理由は1つではなく、Prefillの計算量増大と、DecodeにおけるKVキャッシュ膨張・メモリ帯域律速という異なる性質のボトルネックが絡み合っています。
- GQAやMLAを採用した近年のモデルでは、Tensor Parallelismだけではヘッド単位の分割限界からKVキャッシュの重複が避けられず、同時実行数の天井を押し下げてスループットを頭打ちにします。
- DCPは、KVキャッシュをシーケンス方向に分割するという発想で、既存のTPランク間に生じていたKVキャッシュの重複を減らします。
- ただし、速度やメモリの余裕がDCPサイズに比例して改善するとは限らず、通信オーバーヘッドとのトレードオフもあります。
- ワークロードの入出力長の分布やGPU間インターコネクトの帯域を踏まえたうえで、DCP以外の手法と適材適所で使い分けることが重要です。
詳細な設定や最新の対応モデル一覧は、vLLM公式ドキュメント「Context Parallel Deployment」、およびvLLMブログのDCP解説記事を参照してください。
TP・DCPの検証は、NVLinkのような高速なGPU間インターコネクトを備えた実機がなければ始まらりません。
NVIDIA H200を搭載したGPUを、クラウドで手軽に使える!
国内GPUクラウド「GPUSOROBAN」では、NVLink接続でGPU間通信帯域600GB/sを実現するマルチGPU構成「HGX A100」に加え、NVIDIA H200を搭載しクラスタ構成まで選べる「AIスパコンクラウド」を提供しており、長文LLMの推論検証環境としても選択肢になります。