フィジカルAIとは?Pythonで学ぶ仕組みとエッジ・クラウド連携の実装入門
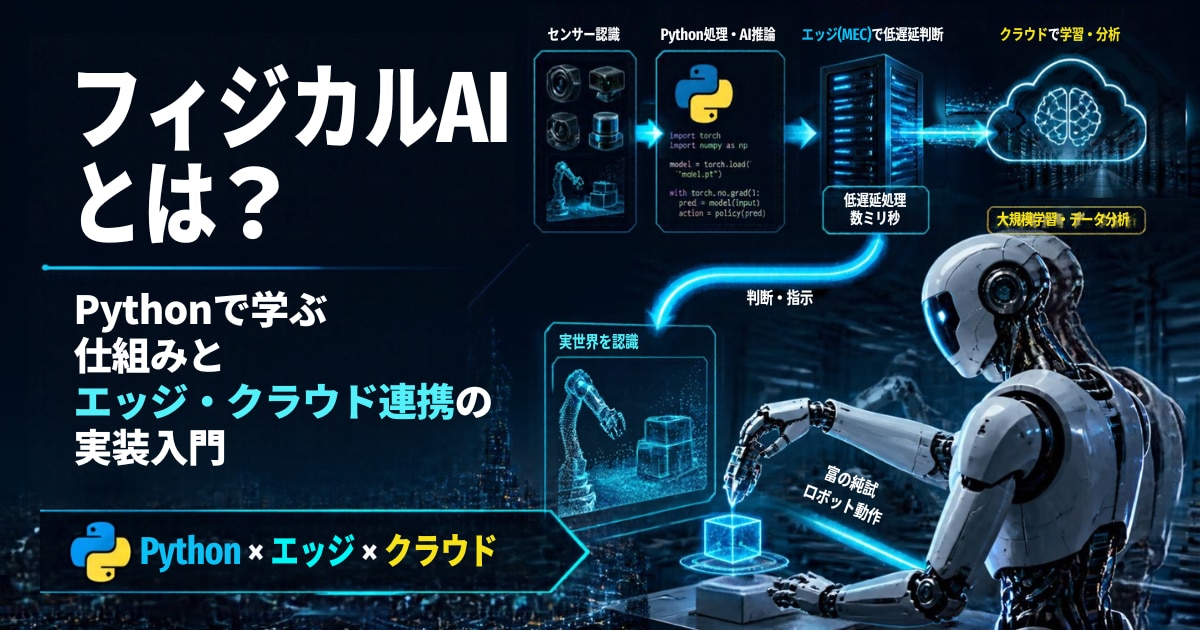
「生成AIの次はフィジカルAI」と言われるようになり、ロボットや自動運転、工場の自動化に関わる方にとって避けて通れないキーワードになりました。一方で、「言葉は聞くけれど、生成AIと何が違うのか」「実際にどうやって開発するのか」がつかみにくいと感じている方も多いのではないでしょうか。
この記事では、
・フィジカルAIの定義とエンボディドAIとの関係
・センサーからアクチュエータまでの仕組み
・VLM・VLA・世界モデル・強化学習
などの主要技術をわかりやすく解説します。
NVIDIA H200を搭載したGPUが、業界最安値で使える!
最先端のNVIDIA H200を、業界最安値クラスでご提供。学習・推論のスピードはそのままに、GPUコストを大幅圧縮。生成AI・LLM学習・シミュレーションなど大規模計算に最適。オンプレミスや他社クラウドと比べても圧倒的に低コストで、最新GPUを手軽に利用できます。
目次[非表示]
- 1.フィジカルAIとは
- 2.フィジカルAIの仕組み
- 3.フィジカルAIを構成する主要技術
- 3.1.センサーフュージョン
- 3.2.VLM・VLA・世界モデル
- 3.3.強化学習
- 3.4.模倣学習
- 3.5.物理シミュレーション
- 4.PythonでフィジカルAIの基本ループを実装する方法
- 4.1.センサー入力と行動を扱うコードを書く
- 4.2.強化学習で簡単なタスクを学習させる
- 4.3.学習結果を可視化する
- 4.4.コードで確認する評価指標
- 5.MECを使う場合の考え方
- 6.フィジカルAI開発を始める5段階
- 6.1.実機なしでシミュレーションする
- 6.2.公開データセットで学習する
- 6.3.カメラ入力と推論を追加する
- 6.4.エッジ端末へ移行する
- 6.5.限定された実機タスクで検証する
- 7.まとめ
フィジカルAIとは
フィジカルAI(Physical AI)とは、カメラやセンサーで現実世界を認識し、AIが状況を理解・判断して、ロボットや機械の「動き」として実行するAIのことです。
NVIDIAはフィジカルAIを「カメラ、ロボット、自動運転車などの自律システムが、物理世界において認識、理解、推論し、複雑な行動の実行や調整ができるようにするもの」と説明しています(出典:NVIDIA「フィジカルAIとは?」)。
ChatGPTに代表される生成AIは、テキストや画像といった「デジタルな出力」を生み出します。これに対してフィジカルAIの出力は、アームの関節角度や車輪の回転速度といった「物理的な動き」です。
フィジカルAIとエンボディドAIの関係
エンボディドAIとは、「知能は身体と環境との相互作用の中で形づくられる」という考え方に基づき、身体を持つエージェントが環境と関わりながら学習・行動するAIを指す研究領域です。
実務上は、両者を厳密に区別する必要はほとんどありません。
フィジカルAIとエンボディドAIは重なる領域が大きいものの、明確な包含関係が定まっているわけではありません。
AI駆動開発の実践方法に関しては、こちらの記事で解説しています。
フィジカルAIの仕組み
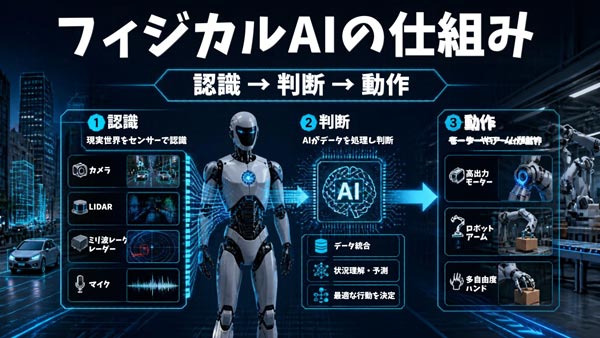
フィジカルAIは、
①センサーで周囲を計測
②AIが環境と目的を理解
③行動計画を作る
④アクチュエータを制御する
という4つのステップを繰り返して動作します。ポイントは、この流れが一方通行ではなく「閉ループ」になっていることです。動いた結果は再びセンサーで計測され、狙いとのずれがあれば次の計画や制御で修正されます。
たとえば、倉庫で「棚から赤い箱を取り出して台車に載せる」ロボットであれば、4つのステップは次のように対応します。
このループは、用途によって1秒間に数回から数千回という速さで回ります。
AIの作り方をエンジニア向け解説した記事はこちらです。
フィジカルAIを構成する主要技術
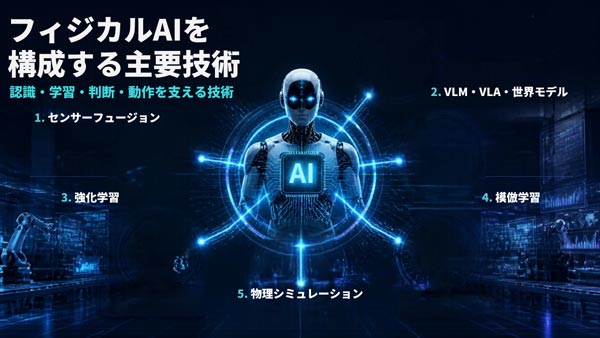
前章の「計測→理解→計画→制御」のループは、いくつもの技術の組み合わせで支えられています。ここでは、フィジカルAIを理解・開発するうえで特に重要な5つの技術を取り上げます。
センサーフュージョン
VLM・VLA・世界モデル
強化学習
模倣学習
物理シミュレーション
POINT | 01 |
センサーフュージョン
センサーフュージョンとは、複数のセンサーから得られた情報を統合し、単一のセンサーよりも正確で信頼できる状態推定を行う技術です。
「センサーで周囲を計測する」で見たとおり、どのセンサーにも得意・不得意があります。カメラは暗所に弱く、LiDARは雨や霧に弱く、IMUは時間とともに誤差が蓄積します。これらを組み合わせて弱点を補い合うことで、「いつでも・どこでも」安定して周囲を把握できるようになります。
代表例が自動運転です。Waymoの第6世代自動運転システムは、13台のカメラ、4台のLiDAR、6台のレーダーを搭載し、車両の全周を重なり合う視野でカバーしています。
POINT | 02 |
VLM・VLA・世界モデル
VLM・VLA・世界モデルは、現在のフィジカルAIの「頭脳」を担う中核技術です。名前が似ているため、まずは3つの違いを整理しておきましょう。
VLMは、画像とテキストを同時に理解し、言葉で答えるモデルです。フィジカルAIでは、「机の上に何があるか」「指示を達成するにはどの順番で作業すべきか」といった状況の理解やタスク計画を担います。
VLAは、VLMにロボットの行動を出力する仕組みを加えたモデルです。VLAの先駆けとされるGoogle DeepMindの「RT-2」は、Webデータとロボットデータの両方から学習し、ロボットの動きをテキストと同じトークンとして出力します。初めて見る物体や背景を含む状況での成功率を、前世代のRT-1の32%から62%に高めました。
世界モデルは、「ある状態で、ある行動をとったら、次に世界がどう変化するか」を予測するモデルです。Metaは世界モデルに求められる能力として、
観測を理解すること
世界の変化を予測すること
目標を達成する行動の順序を計画すること
の3つを挙げています。
(出典:Meta AI)
世界モデルは主に次の3つの用途で使われます。
- 合成データの生成:現実では集めにくい状況の映像を大量に作り出す
- 行動の計画:頭の中でシミュレーションするように、複数の行動案の結果を予測して最善の案を選ぶ
- 方策の評価:学習したAIを実機で試す前に、仮想的に動かして性能を確かめる
NVIDIAはCES 2025で世界基盤モデルのプラットフォーム「Cosmos」を発表し、2026年6月には言語・画像・動画・音声・行動を1つのモデルで扱う「Cosmos 3」の技術レポートを公開しています。
POINT | 03 |
強化学習
強化学習とは、AI(エージェント)が環境の中で行動し、その結果として得られる「報酬」を最大化するように、試行錯誤を通じて行動のルール(方策)を学ぶ手法です。
「うまくいったらほめる」を大量に繰り返すことで、人がルールを書き下すのが難しい動作を獲得できます。
二足歩行やバランス制御のように、物理法則が複雑に絡み合う動作は、人が制御ルールを書き切るのが困難です。
強化学習なら、目標(報酬)を与えるだけで、AI自身が試行錯誤から動かし方を見つけ出します。
POINT | 04 |
模倣学習
模倣学習とは、人が操作したお手本(デモンストレーション)のデータから、ロボットに同じ動作を学ばせる手法です。
強化学習が「自力で試行錯誤して覚える」方法だとすれば、模倣学習は「見て真似して覚える」方法だといえます。報酬を設計する必要がなく、比較的少ないデータで実用的な動作を獲得しやすいため、ロボットアームによる物体操作の分野で急速に普及しています。
デモデータの主な集め方は次のとおりです。
- テレオペレーション:操作者が「リーダーアーム」を動かし、同じ形の「フォロワーアーム」に動きを再現させながら記録する
- VR機器による遠隔操作:VRゴーグルとコントローラーで、ロボットの視点から操作する
- 人の作業動画:人が作業する様子を撮影し、手の動きなどを学習に活用する
模倣学習の基本形である「行動クローニング」には、学習時に見たことのない状態に入ると誤差が雪だるま式に拡大する「分布シフト」という弱点があります。
POINT | 05 |
物理シミュレーション
物理シミュレーションとは、重力・摩擦・衝突といった物理法則をコンピューター上で再現し、その中でロボットを動かす技術です。
シミュレーションの主なメリットは次のとおりです。
- 安全:転倒や衝突を何度繰り返しても、機材の破損やけがが起きない
- 高速・並列:GPUを使って数千台のロボットを同時に動かし、現実の何倍もの速さで経験を積める
- データ生成:正解ラベル付きの画像や動作データを自動で大量に作れる
- 再現性:同じ条件を何度でも再現でき、改良の効果を比べやすい
AI開発に適したプログラミング言語はこちらの記事を参照してみてください。
PythonでフィジカルAIの基本ループを実装する方法
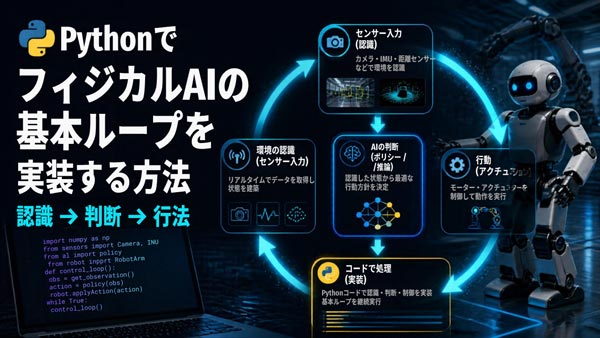
ここからは、フィジカルAIの「計測→理解→計画→制御」のループを、Pythonで実際に動かしてみます。実機のロボットは使わず、手元のPC(GPU不要)だけで再現できる構成にしました。
センサー入力と行動を扱うコードを書く
最初に、「センサーで計測し、判断して、行動する」ループの骨格を作ります。
Gymnasiumの倒立振子環境は、本来ノイズのない理想的な値を返しますが、実機のセンサーには必ず誤差があります。そこで、観測値に正規分布のノイズを加える「NoisySensor」ラッパーを作り、実機に近い条件で試せるようにしました。
また比較対象として、「棒が右に傾いていたら右に押す」という、人が書いた単純なルールベースの制御を用意します。
"""sense_act.py : センサー入力 → 判断 → 行動 の基本ループ"""
import gymnasium as gym
import numpy as np
SENSOR_NAMES = ["台車の位置", "台車の速度", "棒の角度", "棒の角速度"]
class NoisySensor(gym.ObservationWrapper):
"""実機センサーの計測ノイズを模擬するラッパー"""
def init(self, env, noise_std=0.01, seed=None):
super().__init__(env)
self.noise_std = noise_std
self.rng = np.random.default_rng(seed)
def observation(self, obs):
noise = self.rng.normal(0.0, self.noise_std, size=obs.shape)
return (obs + noise).astype(np.float32)
def make_env(noise_std=0.01, seed=None, render_mode=None):
"""CartPole(倒立振子)にセンサーノイズを加えた環境を作る"""
env = gym.make("CartPole-v1", render_mode=render_mode)
return NoisySensor(env, noise_std=noise_std, seed=seed)
def rule_based_policy(obs):
"""人が書いた単純なルール:棒が傾いた側へ台車を押す(0=左, 1=右)"""
angle = obs[2]
return 1 if angle > 0 else 0
def run_episode(env, policy, seed=None):
"""1エピソード分、計測→判断→行動のループを回す"""
obs, info = env.reset(seed=seed) # ① センサーで初期状態を計測
total_reward, steps = 0.0, 0
while True:
action = policy(obs) # ②③ 状態を理解し、行動を決める
obs, reward, terminated, truncated, info = env.step(action) # ④ 行動して再計測
total_reward += reward
steps += 1
if terminated or truncated: # 転倒 or 500ステップ到達で終了
return total_reward, steps, truncated and not terminated
if name == "__main__":
env = make_env(noise_std=0.01, seed=0)
obs, _ = env.reset(seed=0)
print("計測値:", {k: round(float(v), 4) for k, v in zip(SENSOR_NAMES, obs)})
for ep in range(5):
reward, steps, success = run_episode(env, rule_based_policy, seed=ep)
print(f"episode={ep} steps={steps} reward={reward:.0f} success={success}")
env.close()
実行すると、次のように表示されます。
単純なルールでは、30〜50ステップで棒が倒れてしまいました。
棒の角度しか見ておらず、倒れる勢いや台車の位置を考慮していないためです。複数の情報を組み合わせた制御ルールを人が考えるのは意外と難しく、ここに学習の出番があります。
強化学習で簡単なタスクを学習させる
次に、先ほどのルールベースの代わりに、強化学習で「どう押せば倒れないか」をAIに学ばせます。
ライブラリには、PyTorchベースで定番アルゴリズムを手軽に使えるStable-Baselines3を使い、アルゴリズムは前章で紹介したPPOを選びました。
このコードは、強化学習で台車の上の棒を倒さずにバランスさせる制御方策を学習し、結果を保存するスクリプトです。
"""train_rl.py : PPO(強化学習)で倒立振子のバランス制御を学習する"""
import os
from stable_baselines3 import PPO
from stable_baselines3.common.env_util import make_vec_env
from sense_act import make_env
LOG_DIR = "logs"
os.makedirs(LOG_DIR, exist_ok=True)
# 4つの環境を並列に動かし、各エピソードの結果を logs/ に記録する
vec_env = make_vec_env(
lambda: make_env(noise_std=0.01),
n_envs=4,
seed=42,
monitor_dir=LOG_DIR,
)
model = PPO(
"MlpPolicy", # 4つの計測値 → 2つの行動 を出す小さなニューラルネット
vec_env,
learning_rate=3e-4,
n_steps=256,
batch_size=64,
gamma=0.99,
seed=42,
verbose=0,
)
model.learn(total_timesteps=100_000) # 試行錯誤を10万ステップ繰り返す
model.save("ppo_cartpole")
print("学習完了: ppo_cartpole.zip を保存しました")
実行すると、本記事の環境では約90秒で学習が完了し、学習済みモデル「ppo_cartpole.zip」と、エピソードごとの記録が保存されました。
このサンプルは、フィジカルAI開発の縮図になっています。環境を並列に動かして経験を集めるのは、Isaac LabなどでGPU上に数千台のロボットを並べて学習するのと同じ発想です。
学習結果を可視化する
学習がうまく進んだかどうかは、数字だけでなくグラフで確認するのが基本です。ここでは、次の2つを1枚の画像にまとめます。
学習曲線:試行ステップ数に応じて、1エピソードあたりの報酬(倒れずに立っていたステップ数)がどう伸びたか
棒の角度の推移:ルールベースと学習済みAIで、1エピソード中に棒の角度がどう動いたか
以下のコードは学習の成果を2枚のグラフで確認するスクリプトです。左が PPO の学習曲線、右が「ルールベース制御」と「学習済み PPO」の棒の角度の推移の比較で、results.png に保存します。
"""plot_results.py : 学習曲線と、学習前後の「棒の角度」の推移を可視化する"""
import matplotlib
matplotlib.use("Agg") # 画面のない環境でも画像を保存できるようにする
import matplotlib.pyplot as plt
import numpy as np
from stable_baselines3 import PPO
from stable_baselines3.common.monitor import load_results
from sense_act import make_env, rule_based_policy
# --- 1. 学習曲線(logs/ に記録されたエピソードごとの報酬) ---
df = load_results("logs").sort_values("t")
df["timesteps"] = df["l"].cumsum()
df["reward_ma"] = df["r"].rolling(20, min_periods=1).mean()
# --- 2. 1エピソード分の「棒の角度」を記録する ---
def record_angles(policy, seed=0):
env = make_env(noise_std=0.01, seed=seed)
obs, _ = env.reset(seed=seed)
angles = [np.degrees(obs[2])]
while True:
obs, _, terminated, truncated, _ = env.step(policy(obs))
angles.append(np.degrees(obs[2]))
if terminated or truncated:
return angles
model = PPO.load("ppo_cartpole")
ppo_policy = lambda obs: int(model.predict(obs, deterministic=True)[0])
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
axes[0].plot(df["timesteps"], df["r"], alpha=0.3, label="episode reward")
axes[0].plot(df["timesteps"], df["reward_ma"], label="moving average (20)")
axes[0].axhline(500, color="gray", linestyle="--", label="max (500)")
axes[0].set(title="Learning curve (PPO)", xlabel="timesteps", ylabel="reward")
axes[0].legend()
axes[1].plot(record_angles(rule_based_policy), label="rule-based")
axes[1].plot(record_angles(ppo_policy), label="PPO (trained)")
axes[1].axhline(12, color="red", linestyle=":", label="fall limit (±12 deg)")
axes[1].axhline(-12, color="red", linestyle=":")
axes[1].set(title="Pole angle", xlabel="step (20 ms)", ylabel="angle [deg]")
axes[1].legend()
plt.tight_layout()
plt.savefig("results.png", dpi=150)
print("results.png を保存しました")
※Matplotlibは標準では日本語フォントを含まないため、文字化けを避けるためにグラフのラベルは英語にしています。日本語で表示したい場合は、日本語フォントを指定してください。
グラフからは、次のことが読み取れます。
左(学習曲線):学習初期は十数〜数十ステップで倒れていましたが、試行を重ねるにつれて報酬が伸び、移動平均は約4万4,000ステップで上限の500に到達しました。その後は安定して500を維持しています
右(棒の角度):ルールベース(青)は角度の振れが大きくなり、30ステップ弱で転倒ライン(−12度)まで傾いて倒れました。学習済みAI(オレンジ)は、ノイズがある中でも角度をおおむね±6度以内に保ち、500ステップを完走しています
学習曲線が途中で頭打ちになったり、上下に激しく振れ続けたりする場合は、報酬設計や学習率、学習ステップ数を見直すサインです。
コードで確認する評価指標
グラフで傾向をつかんだら、次は評価指標を数値で出します。
フィジカルAIでは、「平均的にうまくいくか」だけでなく、「どれくらいの確率で失敗するか」「制御周期に間に合うか」「条件が悪くなっても耐えられるか」まで確認する必要があります。
本サンプルでは、次の4つの指標を使います。
"""evaluate.py : 成功率・平均報酬・推論時間・ノイズ耐性をまとめて評価する"""
import time
import numpy as np
from stable_baselines3 import PPO
from sense_act import make_env, rule_based_policy
N_EPISODES = 50
model = PPO.load("ppo_cartpole")
def ppo_policy(obs):
return int(model.predict(obs, deterministic=True)[0])
def evaluate(policy, noise_std):
env = make_env(noise_std=noise_std, seed=123)
rewards, successes, infer_ms = [], [], []
for ep in range(N_EPISODES):
obs, _ = env.reset(seed=1000 + ep) # 学習時と違うシードで評価する
total = 0.0
while True:
t0 = time.perf_counter()
action = policy(obs)
infer_ms.append((time.perf_counter() - t0) * 1000)
obs, reward, terminated, truncated, _ = env.step(action)
total += reward
if terminated or truncated:
break
rewards.append(total)
successes.append(truncated and not terminated) # 500ステップ倒れずに完走
return {
"success_rate": np.mean(successes) * 100,
"reward_mean": np.mean(rewards),
"reward_std": np.std(rewards),
"infer_p50_ms": np.percentile(infer_ms, 50),
"infer_p95_ms": np.percentile(infer_ms, 95),
}
print("policy noise success% reward(mean±std) infer p50/p95[ms]")
for name, policy in [("rule-based", rule_based_policy), ("PPO", ppo_policy)]:
for noise in [0.01, 0.05, 0.10]:
m = evaluate(policy, noise)
print(f"{name:<10} {noise:<5} {m['success_rate']:>7.0f} "
f"{m['reward_mean']:>7.1f} ± {m['reward_std']:<6.1f} "
f"{m['infer_p50_ms']:.3f} / {m['infer_p95_ms']:.3f}")
実行結果を表にまとめると、次のとおりです(各条件50エピソード)。
この結果から、次の3つのことがわかります。
学習の効果:ルールベースの成功率0%に対し、学習済みAIは学習時と同じ条件で成功率100%を達成しました
ノイズ耐性の限界:ノイズを学習時の10倍(0.10)にすると、成功率は84%に下がりました。実機に移す前に、実際のセンサーのノイズの大きさを測り、その条件でも評価しておく必要があります
推論時間の余裕:推論時間はp95でも1ミリ秒未満で、制御周期の20ミリ秒に十分間に合っています。ただし、数十億パラメータのVLAでは推論に数十~数百ミリ秒かかることもあり、計算をどこで行うかが問題になります
評価の際は、学習時とは異なる乱数シードを使うこと、十分な回数を試してばらつきも確認することが大切です。
そして最後の「推論時間」の問題を掘り下げるのが、次の章で扱うMECです。
Pythonを用いたAI開発のポイントと注意点に関しては、こちらの記事でまとめています。
MECを使う場合の考え方
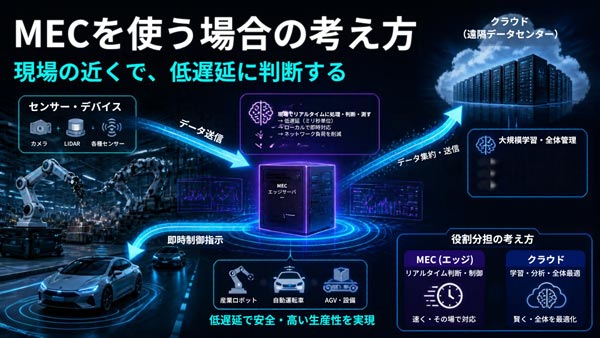
MECとは、通信ネットワークのエッジ、つまりデバイスに近い場所にサーバーを置き、そこで計算処理を行う技術です。
フィジカルAIの推論を「どこで行うか」は、大きく3つの選択肢があります。
※実際の遅延は、回線の種類や混雑状況、サーバーまでの距離によって大きく変わります。必ず自分の環境で実測して判断しましょう。
どこで推論するかを決める基準は、シンプルに「処理が許容できる遅延」と「実際の遅延(特に悪いケース)」の比較です。
「行動計画を作る」で紹介した二層構造に当てはめると、次のように役割を分担するのが基本になります。
エッジ(エッジAI):数十~数百Hzで回す反射的な制御と、通信が途切れたときの安全停止
MEC:端末では重すぎるが、数Hz~数十Hzで結果がほしい画像認識やVLAの推論
クラウド:時間に余裕のあるタスク計画、学習・再学習、複数拠点のデータ集約
MECには、低遅延に加えて、カメラ映像のような大容量データを遠隔のデータセンターまで送らずに処理できるといった利点もあります。
FastAPIで推論APIを作る
まず、MEC(またはクラウド)側に置く推論APIを作ります。Pythonの高速なWebフレームワークFastAPIを使い、エッジ端末から観測値(4つのセンサー値)を受け取って、学習済みモデルが決めた行動を返すシンプルなAPIにします。
このコードは、train_rl.py で学習した PPO モデルを、HTTP のFastAPIとして公開するサーバーです。
"""server.py : 学習済みモデルを推論APIとして公開する(MEC・クラウド側)"""
import time
from contextlib import asynccontextmanager
import numpy as np
from fastapi import FastAPI
from pydantic import BaseModel, Field
from stable_baselines3 import PPO
models = {}
@asynccontextmanager
async def lifespan(app: FastAPI):
models["ppo"] = PPO.load("ppo_cartpole", device="cpu") # 起動時に1回だけ読み込む
yield
models.clear()
app = FastAPI(title="Physical AI Inference API", lifespan=lifespan)
class ObservationIn(BaseModel):
observation: list[float] = Field(..., min_length=4, max_length=4) # 4つの計測値
class ActionOut(BaseModel):
action: int # 0=左に押す, 1=右に押す
inference_ms: float # サーバー内での推論時間
@app.get("/healthz")
def healthz():
return {"status": "ok", "model_loaded": "ppo" in models}
@app.post("/predict", response_model=ActionOut)
def predict(req: ObservationIn):
t0 = time.perf_counter()
obs = np.asarray(req.observation, dtype=np.float32)
action, _ = models["ppo"].predict(obs, deterministic=True)
return ActionOut(action=int(action),
inference_ms=(time.perf_counter() - t0) * 1000)
次のコマンドでサーバーを起動します。ほかの端末から接続する場合は--host 0.0.0.0を指定します。
uvicorn server:app --host 0.0.0.0 --port 8000
別のターミナルから、curlで動作を確認してみましょう。棒が右に傾きながら右へ倒れつつある状態を送ると、「右に押す(1)」が返ってきます。
curl -X POST http://127.0.0.1:8000/predict \
-H "Content-Type: application/json" \
-d '{"observation": [0.0, 0.0, 0.05, 0.5]}'
# => {"action":1,"inference_ms":1.03}(数値は一例)
エッジ側から推論APIを呼び出す
次に、ロボット側のプログラムを作ります。センサーで計測した値を推論APIに送り、返ってきた行動でアクチュエータを動かすループです。
ここで重要なのは、通信を待っている間も物理世界は止まらないということです。シミュレーターはstep()を呼ぶまで時間が止まっていますが、実機では応答を待つ間も棒は倒れ続けます。
そこで、応答に20ミリ秒(1制御周期)以上かかった場合は、遅れた周期の数だけ「直前の行動のまま」環境を進めるようにして、遅延の影響を再現しました。
このコードは、server.py の推論APIを、ロボット側から呼び出して倒立振子を制御するクライアントです。
"""edge_client.py : エッジ端末(ロボット側)から推論APIを呼び出して制御する"""
import time
import httpx
import numpy as np
from sense_act import make_env
CONTROL_PERIOD_MS = 20 # CartPoleの1ステップ = 20ms(50Hz制御)
class RemotePolicy:
"""推論APIを呼び出す方策。失敗時は直前の行動を維持する"""
def __init__(self, url, timeout_ms=200, simulated_rtt_ms=0.0, jitter_ms=0.0, seed=0):
self.client = httpx.Client(base_url=url, timeout=timeout_ms / 1000) # 接続を再利用
self.simulated_rtt_ms = simulated_rtt_ms # 検証用の擬似ネットワーク遅延
self.jitter_ms = jitter_ms
self.rng = np.random.default_rng(seed)
self.last_action = 0
self.log = [] # (遅延ms, API成功したか)
def __call__(self, obs):
t0 = time.perf_counter()
ok = False
try:
if self.simulated_rtt_ms > 0: # 実環境では0にし、MEC上のURLを指定する
delay = self.rng.normal(self.simulated_rtt_ms, self.jitter_ms)
time.sleep(max(delay, 0) / 1000)
res = self.client.post("/predict", json={"observation": obs.tolist()})
res.raise_for_status()
self.last_action = res.json()["action"]
ok = True
except httpx.HTTPError:
pass # タイムアウト・通信エラー時は直前の行動を維持(フォールバック)
latency_ms = (time.perf_counter() - t0) * 1000
self.log.append((latency_ms, ok))
return self.last_action, latency_ms
def run_realtime_episode(env, policy, seed=None):
"""推論の遅れを「物理世界が待ってくれない時間」として反映して1エピソード回す"""
obs, _ = env.reset(seed=seed)
applied = 0
while True:
action, latency_ms = policy(obs)
# 応答を待つ間も時間は進む:遅れた周期ぶん、直前の行動のまま環境を進める
for _ in range(int(latency_ms // CONTROL_PERIOD_MS)):
obs, _, terminated, truncated, _ = env.step(applied)
if terminated or truncated:
return truncated and not terminated
applied = action
obs, _, terminated, truncated, _ = env.step(applied)
if terminated or truncated:
return truncated and not terminated
if __name__ == "__main__":
url = "http://127.0.0.1:8000"
print(httpx.get(f"{url}/healthz").json())
policy = RemotePolicy(url)
success = run_realtime_episode(make_env(noise_std=0.01, seed=0), policy, seed=0)
lat = [l for l, _ in policy.log]
print(f"完走={success} リクエスト数={len(lat)} 平均遅延={np.mean(lat):.2f}ms")
サーバーを起動した状態でpython edge_client.pyを実行すると、次のように表示されました。
p50・p95遅延と成功率を測定する
最後に、推論をどこに置くと制御がうまくいくのかを、数値で比較します。遅延の評価では、平均値ではなくパーセンタイルを使うのが定石です。
平均値は、ときどき発生する大きな遅延(スパイク)に引っ張られたり、逆に隠れてしまったりするためです。
次のコードでは、「エッジ内推論(通信なし)」「MEC想定(追加遅延8±2ミリ秒)」「クラウド想定(往復遅延40±10ミリ秒)」の3パターンを、それぞれ20エピソードずつ実行して比較します。
MEC想定の「追加遅延」は、エッジ側でリクエストの前に意図的に待ち時間を入れ、通信距離を擬似的に上乗せしたものです。
測定値には、この追加遅延に加えて、同じPC上でのHTTP通信、FastAPIによるAPI処理、モデルの推論時間も含まれます。そのため、MEC想定のp50は、設定した追加遅延よりも大きくなっています。
以下のコードは、推論を置く場所ごとに、遅延の分布と、その遅延が制御の成否にどう効くかを測り、1つの表にまとめて比較するスクリプトです。
"""measure_latency.py : p50・p95遅延と各種成功率を配置パターン別に測定する"""
import time
import numpy as np
from stable_baselines3 import PPO
from sense_act import make_env
from edge_client import RemotePolicy, run_realtime_episode, CONTROL_PERIOD_MS
URL = "http://127.0.0.1:8000"
N_EPISODES = 20
class LocalPolicy:
"""比較用:エッジ端末の中で推論する(通信なし)"""
def __init__(self):
self.model = PPO.load("ppo_cartpole", device="cpu")
self.log = []
def __call__(self, obs):
t0 = time.perf_counter()
action = int(self.model.predict(obs, deterministic=True)[0])
latency_ms = (time.perf_counter() - t0) * 1000
self.log.append((latency_ms, True))
return action, latency_ms
scenarios = {
"エッジ内推論": LocalPolicy(),
"MEC想定(追加遅延8±2ms)": RemotePolicy(URL, simulated_rtt_ms=8, jitter_ms=2),
"クラウド想定(RTT 40±10ms)": RemotePolicy(URL, simulated_rtt_ms=40, jitter_ms=10),
}
print(f"{'配置':<24}{'p50':>8}{'p95':>8}{'p99':>8} API成功率 期限内率 タスク成功率")
for name, policy in scenarios.items():
task_ok = [run_realtime_episode(make_env(noise_std=0.01, seed=ep), policy, seed=ep)
for ep in range(N_EPISODES)]
lat = np.array([l for l, _ in policy.log])
api_ok = np.array([ok for _, ok in policy.log])
p50, p95, p99 = np.percentile(lat, [50, 95, 99])
print(f"{name:<24}{p50:>7.2f}ms{p95:>7.2f}ms{p99:>7.2f}ms"
f" {api_ok.mean() * 100:>7.1f}%"
f" {(lat <= CONTROL_PERIOD_MS).mean() * 100:>6.1f}%"
f" {np.mean(task_ok) * 100:>8.0f}%")
実行結果は、次のとおりです。
結果から読み取れるポイントは次の3つです。
- API成功率は全配置で100%であり、クラウド配置の失敗は通信障害ではなく「応答が制御周期(20ms)に間に合わない」ことが原因だと推測されます。
- MEC想定はp99が17.04msで期限内に収まりタスク成功率95%を達成するが、実機ではさらに実網の遅延が乗るため余裕は薄い結果に。
- 推論配置の判断基準は平均やp50ではなく「p99が制御周期を下回るか」であり、これを満たすエッジ・MECは成功し、満たさないクラウド(p99 67ms)は0%となりました。
今回の数値は擬似的な遅延によるものですが、simulated_rtt_ms=0にして実際のMECやクラウド上のサーバーを指定すれば、同じコードで実環境の測定ができます。
初心者向けのAI開発の基本ポイントに関しましては、こちらの記事でまとめています。
フィジカルAI開発を始める5段階
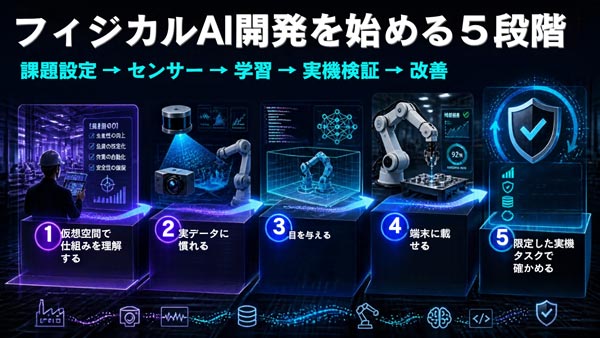
フィジカルAIの開発は、いきなり実機のロボットを買って始めると、費用も時間もかさみ、失敗したときに原因の切り分けも難しくなります。
おすすめは、
仮想空間で仕組みを理解する
実データに慣れる
目を与える
端末に載せる
限定した実機タスクで確かめる
と、段階的に現実へ近づけていく進め方です。
それぞれの段階で「何ができれば次に進んでよいか」を決めておくと、手戻りを減らせます。
このセクションのPythonサンプルは、このうち①と④の一部を体験する内容になっています。
必要な費用も段階的に増えていきます。①はPC1台で始められ、②③で大きなモデルを扱う段階になったら、GPUを搭載したPCや、必要なときだけ時間単位で借りられるGPUクラウドを使うと、初期投資を抑えながら検証を進められます。
POINT | 01 |
実機なしでシミュレーションする
最初の段階では、実機を使わずにシミュレーションの中で「計測→判断→行動」のループと、学習・評価のサイクルを一通り体験します。本記事のCartPoleのサンプルが、まさにこの段階の入り口です。
CartPoleで流れをつかんだら、物理エンジンMuJoCoを使ったGymnasiumの環境に進みましょう。pip install "gymnasium[mujoco]"でインストールでき、本記事のコードの環境名を変えるだけで試せます。
MuJoCoの環境では行動が「押す/押さない」の2択ではなく、連続的なトルクになります。アルゴリズムをPPOのまま試すほか、連続制御と相性の良いSACに切り替えて比べてみるのもよいでしょう。
観測と行動の次元が増えるほど学習に必要なステップ数は増えるため、本格的に取り組む段階では、GPUで数千の環境を並列に動かせるIsaac LabやMuJoCo Playgroundへ移行します。
この段階で身につけておきたいのは、次のような「実験の型」です。
報酬を何にするかを言葉で説明できる
- 学習曲線と評価指標(成功率・ばらつき・推論時間)で結果を示せる
- ノイズやパラメータのランダム化を加え、条件が変わっても性能が保てるかを確認できる
POINT | 02 |
公開データセットで学習する
シミュレーションの次は、実際のロボットで集められた公開データセットに触れます。
自分でデータを集める前に、実ロボットのデータがどのような形式で、どのくらいの量が必要なのかを知っておくと、後の段階での設計がスムーズになります。
(出典:Open X-Embodiment、DROID、LeRobot)
データに慣れたら、公開されている学習済みモデルを自分のタスク向けに追加学習(ファインチューニング)してみましょう。LeRobotでは、ACTやDiffusion Policyに加え、SmolVLAやπ0系、NVIDIAのGR00TといったVLAも扱えます。最初は約4.5億パラメータと小型のSmolVLAから始めると、比較的手頃な計算資源で試せます。
この段階で注意したいポイントは次の3つです。
ライセンスを確認する:データセットやモデルごとに、商用利用の可否や条件が異なります
ロボットの違いを意識する:関節の数、カメラの位置、行動の表し方(関節角度か手先位置か)が、自分の環境と合っているかを確認します
計算資源を見積もる:VLAのファインチューニングにはGPUが必要です。手元にGPUがない場合は、GPUクラウドを必要な時間だけ利用する方法が現実的です
POINT | 03 |
カメラ入力と推論を追加する
3つ目の段階では、ロボットに「目」を与えます。CartPoleでは4つの数値が直接得られましたが、現実のタスクでは、カメラ画像から物体の位置や状態を読み取る必要があります。
まずはPCにUSBカメラをつなぎ、「撮影→前処理→推論」の1周にかかる時間を測るところから始めましょう。次のコードのinfer関数を、物体検出モデルやVLM・VLAの推論に置き換えていきます(OpenCVはpip install opencv-pythonでインストールできます)。
このコードは、「カメラ画像を取り込んで推論するまでの1周」にどれくらい時間がかかるかを、p50・p95・p99で計測するものです。
"""camera_loop.py : カメラ入力 → 前処理 → 推論 の1周にかかる時間を測る"""
import sys
import time
import cv2
import numpy as np
source = sys.argv[1] if len(sys.argv) > 1 else 0 # 0 = PCにつないだUSBカメラ
cap = cv2.VideoCapture(source)
cap.set(cv2.CAP_PROP_FRAME_WIDTH, 640)
cap.set(cv2.CAP_PROP_FRAME_HEIGHT, 480)
def infer(image):
"""ここを物体検出・VLM・VLAなどの推論に置き換える(今は平均輝度を返すだけ)"""
return float(image.mean())
lat_ms = []
for _ in range(300):
t0 = time.perf_counter()
ok, frame = cap.read() # ① 計測(撮影・転送)
if not ok:
break
x = cv2.resize(frame, (224, 224)) # 前処理:モデルの入力サイズに合わせる
x = cv2.cvtColor(x, cv2.COLOR_BGR2RGB).astype(np.float32) / 255.0
result = infer(x) # ② 理解・③ 計画(推論)
lat_ms.append((time.perf_counter() - t0) * 1000)
cap.release()
p50, p95, p99 = np.percentile(lat_ms, [50, 95, 99])
print(f"frames={len(lat_ms)} p50={p50:.1f}ms p95={p95:.1f}ms p99={p99:.1f}ms")
実際のカメラでは、cap.read()が次のフレームを待つため、30fpsのカメラなら1周に約33ミリ秒以上かかります。
つまり、カメラを使った時点で「制御周期20ミリ秒」は成り立たなくなる、ということです。このように、カメラを加える段階では、処理全体を遅延予算として分解して考えることが大切です。
あわせて、カメラの内部パラメータや取り付け位置のキャリブレーション、照明条件の変化への対策も、この段階で確認しておきましょう。
ロボットアームでは、手首に付けたカメラと作業全体を見渡すカメラを併用する構成も広く使われています。
POINT | 04 |
エッジ端末へ移行する
4つ目の段階では、PCで動かしていた推論を、ロボットに搭載できる小型・省電力なエッジ端末へ移します。
このように、クラウドに頼らず端末側でAIの推論を実行する仕組みをエッジAIと呼びます。通信が途切れても動き続けられること、そして前章で見たように遅延を最小にできることが、フィジカルAIでエッジAIを活用する利点です。
(出典:Raspberry Pi、CNX Software(Jetson Orin Nano Super)、CNX Software(Jetson AGX Thor))
エッジ端末へ移す際は、学習に使ったフレームワークのまま動かすのではなく、推論に特化した形式へ変換するのが一般的です。
代表的な方法が、モデルをONNX形式に書き出し、ONNX RuntimeやTensorRTで実行する方法です。
"""export_onnx.py : 学習済み方策をONNX形式に変換し、ONNX Runtimeで推論時間を測る"""
import time
import numpy as np
import onnxruntime as ort
import torch
from stable_baselines3 import PPO
class OnnxablePolicy(torch.nn.Module):
"""観測 → 行動ロジット だけを取り出した軽量モデル"""
def __init__(self, policy):
super().__init__()
self.policy = policy
def forward(self, obs):
features = self.policy.extract_features(obs, self.policy.pi_features_extractor)
latent_pi = self.policy.mlp_extractor.forward_actor(features)
return self.policy.action_net(latent_pi)
model = PPO.load("ppo_cartpole", device="cpu")
dummy = torch.zeros(1, 4, dtype=torch.float32)
torch.onnx.export(OnnxablePolicy(model.policy), dummy, "policy.onnx",
input_names=["obs"], output_names=["logits"])
session = ort.InferenceSession("policy.onnx", providers=["CPUExecutionProvider"])
obs = np.array([[0.0, 0.0, 0.05, 0.5]], dtype=np.float32)
lat = []
for _ in range(1000):
t0 = time.perf_counter()
logits = session.run(None, {"obs": obs})[0]
lat.append((time.perf_counter() - t0) * 1000)
print("ONNX action:", int(np.argmax(logits)),
"/ SB3 action:", int(model.predict(obs[0], deterministic=True)[0]))
print(f"ONNX Runtime p50={np.percentile(lat, 50):.3f}ms p95={np.percentile(lat, 95):.3f}ms")
本記事の環境では、変換前と同じ行動を出力しつつ、推論時間はp50で約0.011ミリ秒になりました。Stable-Baselines3のpredict(p50で約0.39ミリ秒)と比べて大幅に短縮できています。
text
ONNX action: 1 / SB3 action: 1
ONNX Runtime p50=0.011ms p95=0.017ms
エッジへの移行では、次の点もあわせて確認しましょう。
- 量子化:FP16やINT8など、数値の精度を落としてモデルを軽くする。精度がどれだけ落ちるかを評価指標で必ず確認する
- 電力と発熱:長時間動かすと発熱で性能が落ちる(サーマルスロットリング)ことがあるため、連続稼働での遅延も確認する
- 役割分担:端末で動かしきれない大きなモデルはMECに置き、端末には高頻度の制御と安全停止を残す
POINT | 05 |
限定された実機タスクで検証する
最後の段階で、いよいよ実機を動かします。ここで大切なのは、最初から汎用的なロボットを目指さず、「決まった場所にある1種類の物体をつかんで箱に入れる」のように、条件を絞り込んだタスクから始めることです。
条件を限定すれば、失敗したときに原因を特定しやすく、安全も確保しやすくなります。
入門には、LeRobotが対応している低価格ロボットアーム「SO-101」などが適しています。リーダーアームで操作してデモを記録し、ACTなどで学習させて実機にデプロイする流れを、比較的少ない予算で一通り試せます。
実機の検証では、あらかじめ次のような計画を立てておきましょう。
安全面では、次の対策を必ず講じてください。
速度と力の上限を低めに設定する
手の届く位置に非常停止スイッチを置く
ロボットの動作範囲を明示し、検証中は人が立ち入らないようにする
AIの判断とは独立して動く停止の仕組みを用意する
- 工場などに導入する段階では、リスクアセスメントを実施し、労働安全衛生規則などの法令や、産業用ロボットの安全規格への適合を確認する
実機での結果をもとに、シミュレーションの物理パラメータやデータ収集の方法を見直し、①〜⑤を繰り返し改善していくことが、実用的なフィジカルAIへの近道です。
AI開発に必要なクラウドインフラに関しましては、こちらの記事を参考にしてみてください。
まとめ
フィジカルAIは、センサーで現実世界を認識し、AIが判断して、ロボットや機械の動きとして実行するAIです。生成AIが「デジタルな出力」を生み出すのに対し、フィジカルAIは「物理的な動き」を生み出すため、精度だけでなくリアルタイム性と安全性が求められます。
国内外で投資と技術開発が加速する今、フィジカルAIはロボット専門家だけのものではなくなりつつあります。まずは本記事のサンプルコードを手元で動かし、「計測→判断→行動」のループと、遅延が物理世界に与える影響を体感するところから始めてみてください。
本格的に取り組むなら、GPUSOROBANで開発を加速
サンプルのような小さなモデルは手元のPCでも動きますが、物体検出・VLM・VLAといった実用的なモデルの学習や検証には、大規模なGPUリソースが欠かせません。
GPUSOROBANなら、必要なときに必要な分だけGPUを活用でき、フィジカルAIの試作から検証までをスピーディーに進められます。サービスの詳細や導入のご相談は、ぜひ資料請求からお気軽にお問い合わせください。