生成AIをプロダクトに組み込む前に知っておきたい|クラウドコスト最適化の基本
生成AI機能をプロダクトに組み込むプロジェクトが増えていますが、「PoCでは数万円だったのに、本番リリース後にクラウド費用が想定の何倍にも膨れ上がった」という声も同じくらいよく聞きます。
原因の多くは、コストの数え方そのものが従来のWebサービスと違うことに気づかないまま予算を組んでしまう点にあります。
この記事では、生成AI機能を持つプロダクトを本番化する前に、クラウドコストをどう洗い出し、どう試算し、どう抑えるかを整理します。
NVIDIA H200を搭載したGPUが、業界最安値で使える!
最先端のNVIDIA H200を、業界最安値クラスでご提供。学習・推論のスピードはそのままに、GPUコストを大幅圧縮。生成AI・LLM学習・シミュレーションなど大規模計算に最適。オンプレミスや他社クラウドと比べても圧倒的に低コストで、最新GPUを手軽に利用できます。
目次[非表示]
- 1.生成AIをプロダクトに組み込むとクラウドコストはなぜ増えやすい?
- 2.生成AIプロダクトで発生するクラウドコストの内訳
- 3.本番導入前にクラウドコストを試算する4ステップ
- 3.1.月間ユーザー数とAI利用回数を仮置きする
- 3.2.1リクエストあたりの入力・出力トークンを測る
- 3.3.ピーク同時実行数と必要レイテンシを決める
- 3.4.「1リクエスト・1ユーザーあたり原価」に変換する
- 4.計測して初めて分かる3つの数字
- 5.生成AIのクラウドコストが高くなる7つの原因
- 5.1.必要以上に大きなモデルを使っている
- 5.2.入力・出力トークンが長すぎる
- 5.3.GPUを確保しているのに利用率が低い
- 5.4.ピーク負荷に合わせて常時オーバープロビジョニングしている
- 5.5.キャッシュ・バッチ処理を使えていない
- 5.6.開発・検証用リソースを放置している
- 5.7.ストレージ・データ転送・ログ費を見落としている
- 6.API型と自前ホスティング、どちらが安いのか
- 7.生成AIのクラウドコストを最適化する8つの方法
- 7.1.要件を満たす最小モデルから選ぶ
- 7.2.プロンプトとコンテキストを短くする
- 7.3.キャッシュ・バッチ・非同期処理を使い分ける
- 7.4.GPU・インスタンスをライトサイジングする
- 7.5.オートスケーリングと自動停止を設定する
- 7.6.ストレージ・ネットワーク・ログの保持条件を見直す
- 7.7.安定稼働するリソースは割引・予約枠を検討する
- 7.8.クラウドコストとAIの事業価値をセットで評価する
- 8.コスト構造を把握したら、GPU基盤の選び方を見直そう
生成AIをプロダクトに組み込むとクラウドコストはなぜ増えやすい?
一般的なWebサービスのクラウドコストは、CPU・メモリ・DB・通信量が中心です。エンジニアはこれらの見積もりに慣れています。
一方、生成AIをプロダクトに組み込むと、これに次のようなコスト項目が上乗せされます。
- モデル利用料・トークン課金
- GPU・アクセラレータ
- 推論サーバーの常時稼働費
- ベクトルDB
- AIログ・評価基盤
これらは従来のコスト感覚では見積もりにくいうえ、API型では従量的、自前ホスティングでは固定費やGPU追加に伴う階段状の増加など、構成によってコストの増え方も異なります。
まずはこの「コストの数え方」の違いを押さえておきます。
生成AIでは「1ユーザー」ではなくトークン・GPU時間がコストを左右する
従来のWebサービスは「月間ユーザー数 × サーバー費」で概算できました。しかし生成AIのコストは、利用形態によって単位そのものが異なります。
API型を使う場合は、入力トークン数、出力トークン数、関数呼び出しなどの合計で課金されます。同じ「1回の利用」でも、ユーザーが長文を貼り付けたか短い質問をしたかで原価が数倍〜数十倍変わります。
自前でモデルをホスティングして推論する場合は、GPUの稼働時間、ストレージ、ネットワーク転送量、運用にかかる人件費が中心になります。リクエスト数がゼロでも、GPUを起動している限り課金は発生し続けます。
画像・動画生成のようなモダリティでは、生成回数や解像度・処理時間に応じた独自の課金単位を持つサービスも多く、テキスト生成とは別軸で試算する必要があります。
つまり「月間ユーザー数×サーバー費」という従来の一次式だけでは、生成AI機能のコストは試算できません。トークン量・GPU時間・生成回数といった、利用形態ごとの単位に分解して考える必要があります。
PoCでは安くても本番化するとコストが跳ねやすい
PoC段階では、少人数の社内利用や限られたシナリオでの検証が中心なので、API利用料も月数千円〜数万円程度に収まることがあります。ここで得られたコスト感を、そのまま本番予算の根拠にしてしまうのがよくある失敗です。
しかし本番化すると、次のような要因が積み重なってコストが跳ね上がってしまいます。
- ユーザー数がPoC時の何十倍にも増える
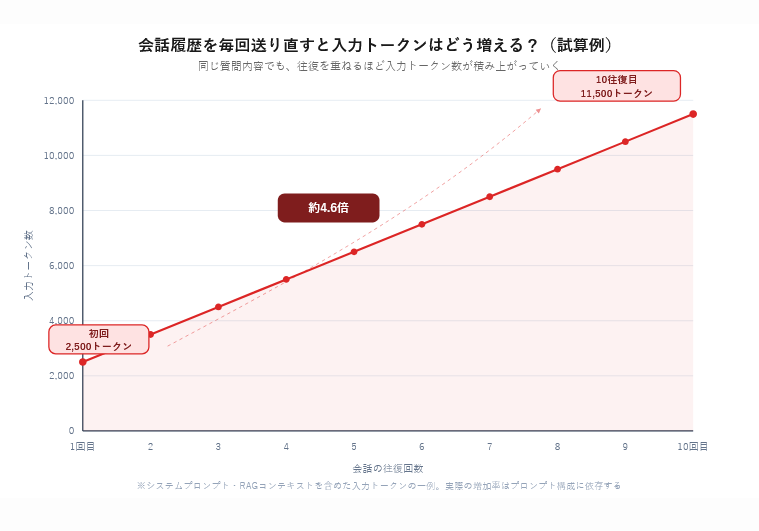
- 会話履歴を持たせることで、同じ質問でも入力トークンが増えていく
- キャンペーンや業務時間帯にリクエストが集中する(ピーク同時実行)
- 可用性確保のための冗長化(複数リージョン・複数インスタンス)
- 監視・ログ基盤の追加
- 開発・ステージング環境の並行運用
PoC時のAPI利用料だけを本番予算のベースラインにするのではなく、次章以降で説明する内訳とステップに沿って、本番運用を前提とした試算をやり直すことが重要です。
例えば、初回の入力が2,500トークンで、その後のやり取りによって会話履歴が1往復あたり約1,000トークンずつ増えるケースを考えると、10往復目には入力が11,500トークン程度に達します。
これは初回の約4.6倍です。実際の増加量はユーザー入力やモデルの回答の長さによって異なります。
PoCの検証は数往復で終わることが多いため、この増加分が見えないまま本番予算を組んでしまうと、想定より大きくコストが跳ねる原因になります。
POCの次のステップとして、本番運用に必要なインフラの考え方に関しては、こちらの記事で詳しく解説しています。
生成AIプロダクトで発生するクラウドコストの内訳
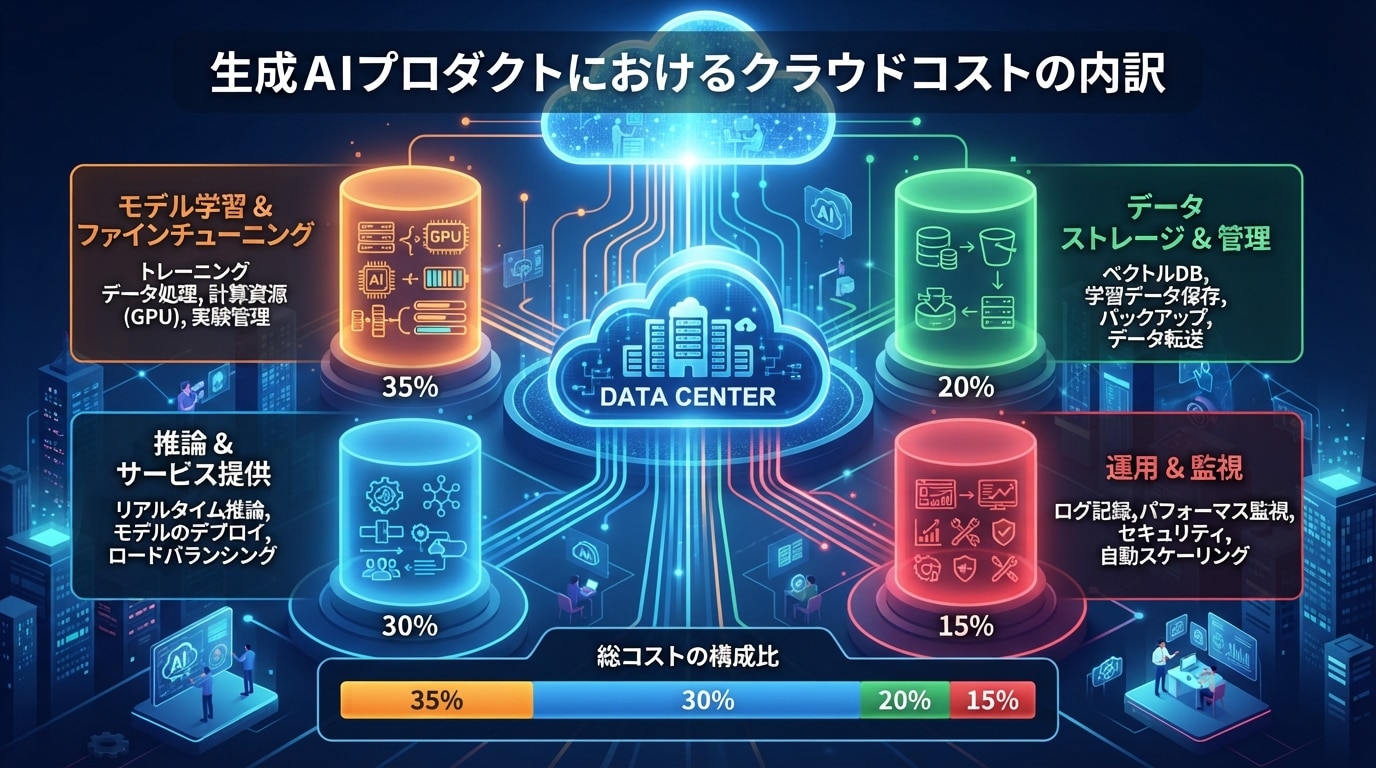
生成AI機能を含むプロダクトのクラウドコストは、大きく分けて次の項目から構成されます。
全体像を把握してから、自分たちのアーキテクチャではどの項目が効いてくるかを確認してみてください。
項目 | 内容 |
|---|---|
API利用料 | OpenAI・Anthropic・Bedrock・Vertex AI等の入出力トークン課金、キャッシュ利用料、組み込みツール利用料など。 |
GPU | 自前推論のための計算リソース。オンデマンド or 予約インスタンス |
推論基盤 | 推論サーバー、オートスケーリング基盤、ロードバランサー、キュー |
ストレージ | モデルの重み、生成物(画像・動画)、会話ログの保存 |
ベクトルDB | RAG用の埋め込みインデックス |
データ転送 | リージョン間・クラウド間・外部APIとの通信量 |
監視ログ | トレーシング、プロンプト・レスポンスのロギング、評価基盤 |
開発・検証環境 | PoC用リソース、ステージング環境、負荷試験環境 |
冗長化 | 複数AZ・複数リージョンでの可用性確保にかかる追加コスト |
運用人件費 | プロンプト改修、モデル切り替え、コスト監視などの運用工数 |
10項目それぞれが、実際のリクエスト処理のどの段階で発生するのかを重ねて示したのが次の図です。①〜⑩の番号が表の項目に対応しています。
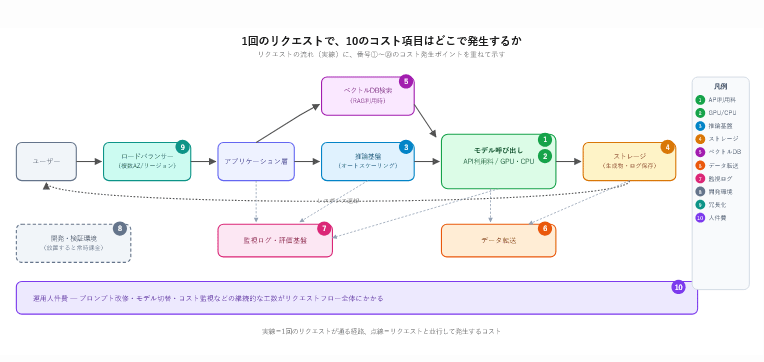
以下は、これらの項目がプロダクトのどこに位置するかを示した概念図です。
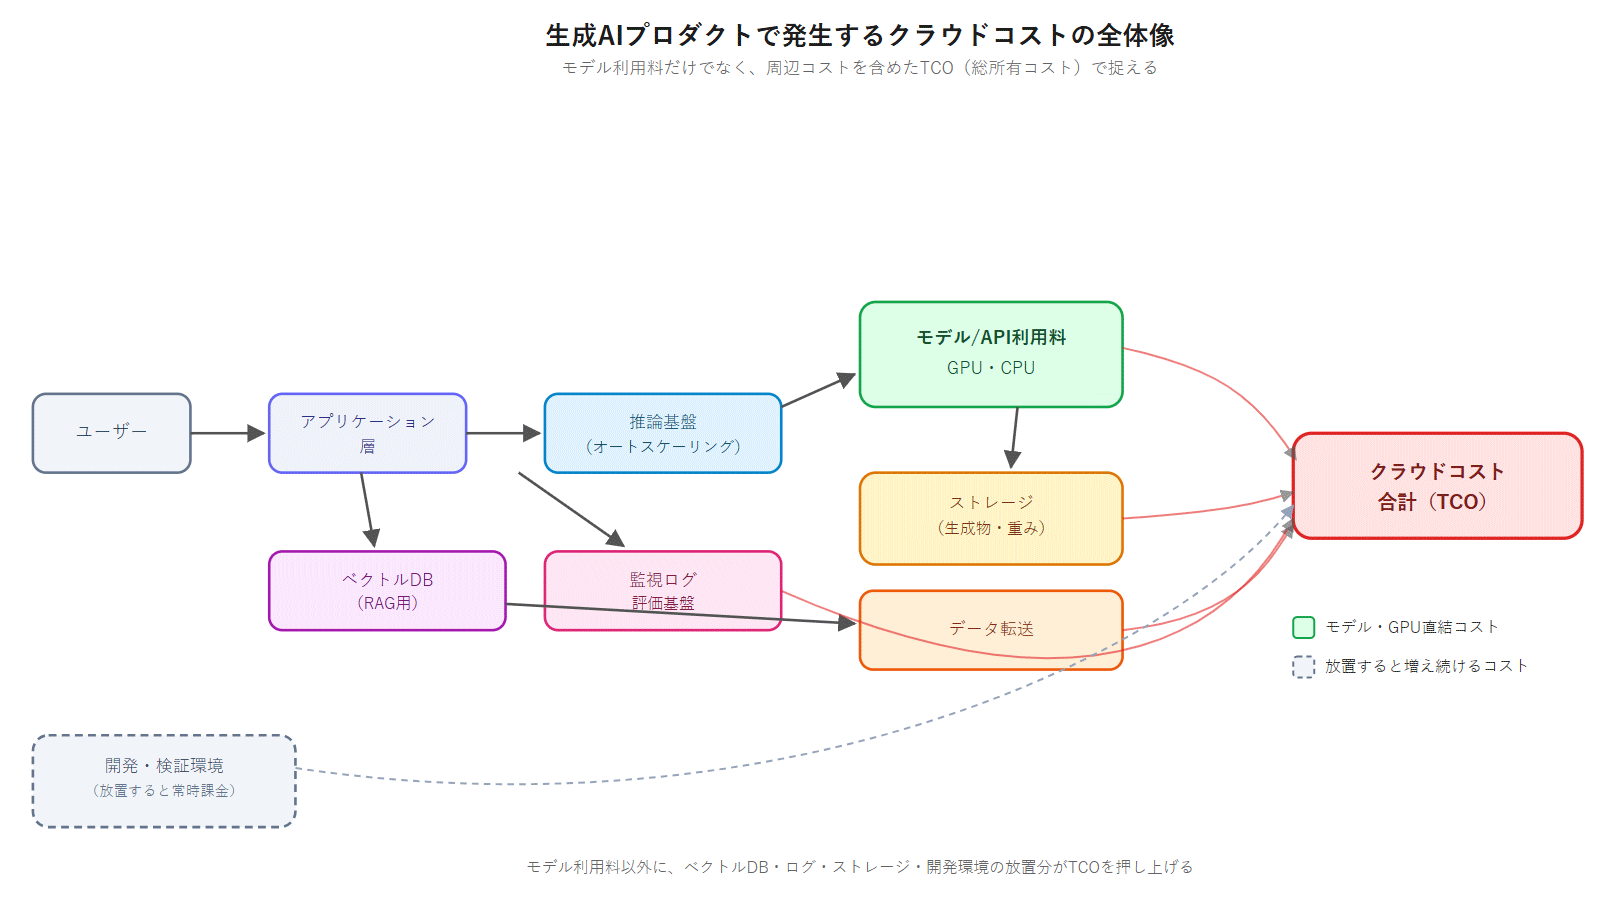
「モデル利用料を把握すれば十分」と考えがちですが、実際にはベクトルDB・ログ基盤・開発環境の放置分が想像以上に効いてくるケースが多く、総所有コストとして見る視点が必要です。
実際にかかるクラウドコストの具体的な料金体系に関しては、こちらの記事で紹介しています。
本番導入前にクラウドコストを試算する4ステップ
内訳を把握したら、実際に本番導入前の試算を行います。ここでは4つのステップに分けて進めます。
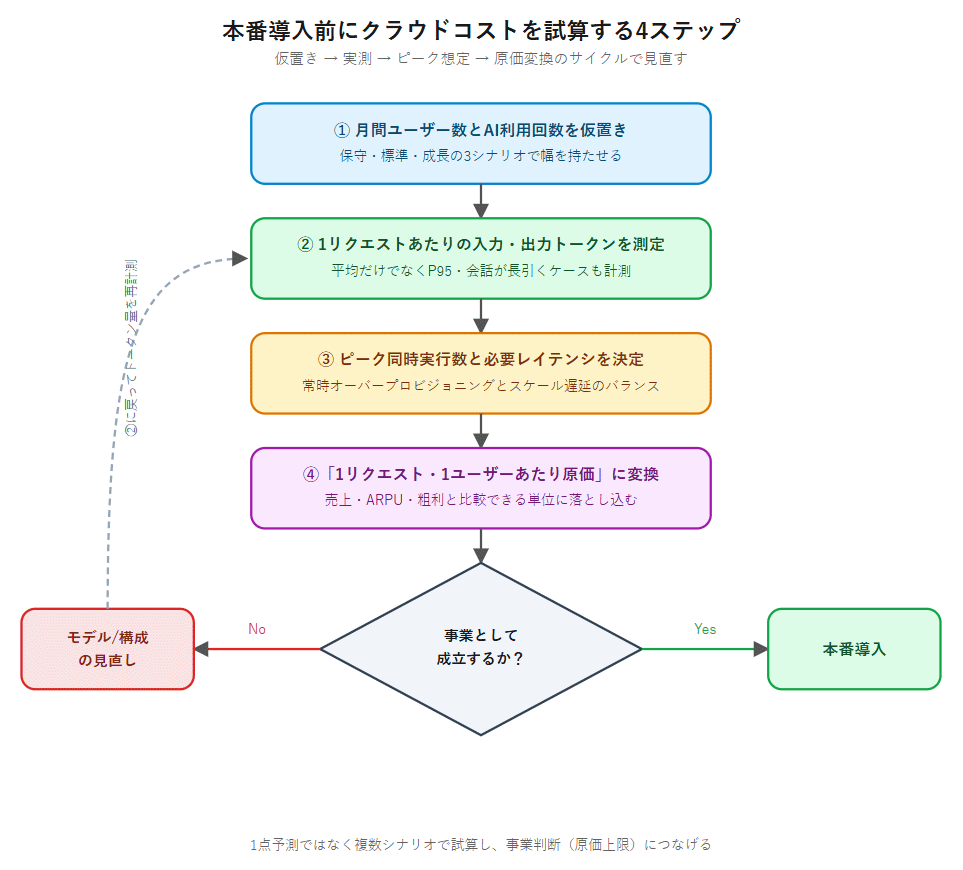
STEP
01
月間ユーザー数とAI利用回数を仮置きする
まず、月間アクティブユーザー数(MAU)と、そのうち生成AI機能を使うユーザーの割合、1人あたりの月間利用回数を仮置きします。
例えば「MAU 10,000人 × AI利用率30% × 1人月20回 = 月60,000リクエスト」といった形です。
このとき重要なのは、1点の数字で予測しないことです。保守的シナリオ・標準シナリオ・成長シナリオの3パターンで幅を持たせておくと、後段のコスト試算にも同じ幅を引き継げます。
生成AI機能はユーザーの利用習慣を事前に予測しにくいため、成長シナリオでは標準シナリオを大きく上回る利用率も置き、コストへの影響を感度分析しておきましょう。
STEP
02
1リクエストあたりの入力・出力トークンを測る
次に、実際のプロンプトと、想定される回答の長さから、1リクエストあたりの入力・出力トークン数を測定します。
平均値だけでなく、P95(上位5%の重いリクエスト)程度まで記録しておくと、後述するピーク時のコストやレイテンシの試算に役立ちます。
チャット形式のように会話履歴を保持する機能では、会話が長くなるほど入力トークンが増えていくため、「初回のやり取り」と「10往復後のやり取り」を別シナリオとして計測しておくのがおすすめです。
STEP
03
ピーク同時実行数と必要レイテンシを決める
自前でGPU基盤を用意する場合は、平均的なリクエスト数だけでなく、ピーク時の同時実行数と、ユーザーに約束するレイテンシを決める必要があります。
ピークに合わせて常時GPUを確保すると、閑散時間帯のアイドル費用が積み上がります。かといってスケールアウトが遅いと、ピーク時にレイテンシが悪化してユーザー体験を損ないます。オートスケーリングの立ち上がり時間やキューイングの許容遅延も含めて、スケール方式ごとにコストを試算しておく必要があります。
STEP
04
「1リクエスト・1ユーザーあたり原価」に変換する
最後に、これまでの試算を事業判断に使える単位に変換します。
月間AI関連クラウドコスト ÷ 月間AIリクエスト数 = 1リクエストあたり原価
月間AI関連クラウドコスト ÷ AI利用ユーザー数 = 1ユーザーあたり原価
この原価を、売上・ARPU・粗利と比較することで、「生成AI機能を無料で提供し続けられるか」「有料プランのどの価格帯なら採算が取れるか」といった、事業として成立するコスト上限を決められます。
エンジニアが試算した原価データを、事業側の意思決定にそのまま使える形で渡せることが、このステップの狙いです。
計測して初めて分かる3つの数字
ここまでの試算は、あくまで仮置きの数字から始まっています。本番導入を判断する前には、仮置きした数字を実測値に置き換える必要があります。
ここでは、生成AIプロダクトで特に見落とされがちな3つの指標と、その具体的な計測手段をコードベースで紹介します。本文中で繰り返し出てきた計測タスクを実践して活用してみます。
平均値では危険:P95で見るべき理由
平均トークン数だけを見ていると、長い会話履歴を持つユーザーや長文プロンプトを投げるユーザーの影響を過小評価してしまいます。前章の試算例のように、平均が4,000トークンでも、一部のユーザーは10往復を超えて11,500トークンに達している、といった分布はよくあります。
アプリのログにリクエストごとの入出力トークン数を記録しておけば、以下のようなPythonで簡単に分布を確認できます。
import numpy as np
# ログから収集した1リクエストあたりの入力トークン数(例:直近1日分)
input_tokens = [1800, 2500, 3100, 4200, 5300, 11500, 2100, 3900, ...]
p50 = np.percentile(input_tokens, 50)
p95 = np.percentile(input_tokens, 95)
p99 = np.percentile(input_tokens, 99)
print(f"P50: {p50:.0f} トークン / P95: {p95:.0f} トークン / P99: {p99:.0f} トークン")
ログをBigQueryやCloudWatch Logs Insightsなど分析用のストアに集約している場合は、集計も以下のようなSQLで済ませられます。
APPROX_QUANTILES(input_tokens, 100)[OFFSET(50)] AS p50,
APPROX_QUANTILES(input_tokens, 100)[OFFSET(95)] AS p95,
APPROX_QUANTILES(input_tokens, 100)[OFFSET(99)] AS p99
FROM `project.dataset.llm_request_logs`
WHERE request_date = CURRENT_DATE('Asia/Tokyo')
TTFTとtokens/sec:体験に直結する2指標
コストと同じくらい重要なのが、ユーザー体験に直結する速度の指標です。
- TTFT(Time To First Token):リクエストを送ってから最初のトークンが返ってくるまでの時間。この時間が長いと「待たされている」と感じられます。
- tokens/sec:ストリーミング中の生成速度。人がテキストを読む速度より遅いと、生成が追いつかず不自然な間が生まれます。
ストリーミングAPIを使っている場合、TTFTは最初のテキストを受信した時刻から計測できます。
一方、ストリームのチャンク数はトークン数とは一致しないため、tokens/secはAPIが返す出力トークン数、または使用モデルに対応したtokenizerで数えたトークン数を使って算出します。
以下は考え方を示す簡略化したコード例です。
start = time.perf_counter()
first_token_time = None
generated_text = ""
for chunk in stream: # ストリーミングAPIのレスポンスをイテレート
text = get_text_from_chunk(chunk) # SDKに応じてテキスト部分を取得
if text:
if first_token_time is None:
first_token_time = time.perf_counter()
generated_text += text
end = time.perf_counter()
ttft = first_token_time - start
# 対応するtokenizerで生成テキストのトークン数を数える
output_tokens = count_tokens(generated_text)
generation_time = end - first_token_time
tokens_per_sec = output_tokens / generation_time
print(f"TTFT: {ttft:.3f}秒 / 生成速度: {tokens_per_sec:.1f} tokens/sec")</code></pre>
この値をリクエストごとにログへ書き出し、前項と同じようにP50・P95で追跡することで、「平均は速いが、一部のリクエストだけ極端に遅い」といった状態を早期に検知できます。
GPU利用率と待機キュー長
自前でGPU推論基盤を持つ場合は、GPU利用率と待機キュー長を継続的に見る必要があります。この2つが、「GPUを確保しているのに使われていない」状態と「GPUが足りずリクエストが詰まっている」状態を見分ける手がかりになります。
GPU利用率は、nvidia-smiで確認できます。
# GPU利用率・メモリ使用量を1秒間隔で取得
nvidia-smi --query-gpu=utilization.gpu,memory.used,memory.total --format=csv -l 1
vLLMのような推論サーバーは、Prometheus形式のメトリクスを公開しています。
メトリクス名はバージョンによって変更される場合があるため、利用中のバージョンの公式ドキュメントも確認してください。
待機キュー長は次のようなクエリで確認できます。
# 実行待ちのリクエスト数(待機キュー長)
vllm:num_requests_waiting
# GPU側のKVキャッシュ使用率
vllm:kv_cache_usage_perc
待機キュー長が0に近く、GPU利用率も低い状態が長時間続いている場合は、GPUを過剰に確保している可能性があります。
逆に、ピーク時に待機キューが伸び続けるなら、オートスケーリングの追従が遅い、またはGPU台数が不足しているサインです。
最低限そろえたいダッシュボード項目
ここまでの指標は、都度スクリプトを実行するのではなく、日次で確認できるダッシュボードにまとめておくことをおすすめします。最低限そろえておきたい項目を整理します。
指標 | 見るポイント | 取得元の例 |
|---|---|---|
入力/出力トークン | ロングテールのコスト影響 | アプリログ、BigQuery/CloudWatch Logs Insights |
TTFT | 最初の応答までの待ち時間 | クライアント計測ログ |
tokens/sec | ストリーミング中の生成速度 | クライアント計測ログ |
GPU利用率 | アイドル/過負荷の判定 |
|
待機キュー長 | スケールアウトのタイミング | 推論サーバーのメトリクス |
1リクエスト/1ユーザー原価 | 事業判断の材料 | コスト集計バッチ |
これらを1枚のダッシュボードに並べておけば、「コストが上がった」ときに、トークン量の増加なのか、GPU利用率の低下なのか、単純なリクエスト数の増加なのかを、数字を見ながら切り分けられるようになります。
生成AIのクラウドコストが高くなる7つの原因
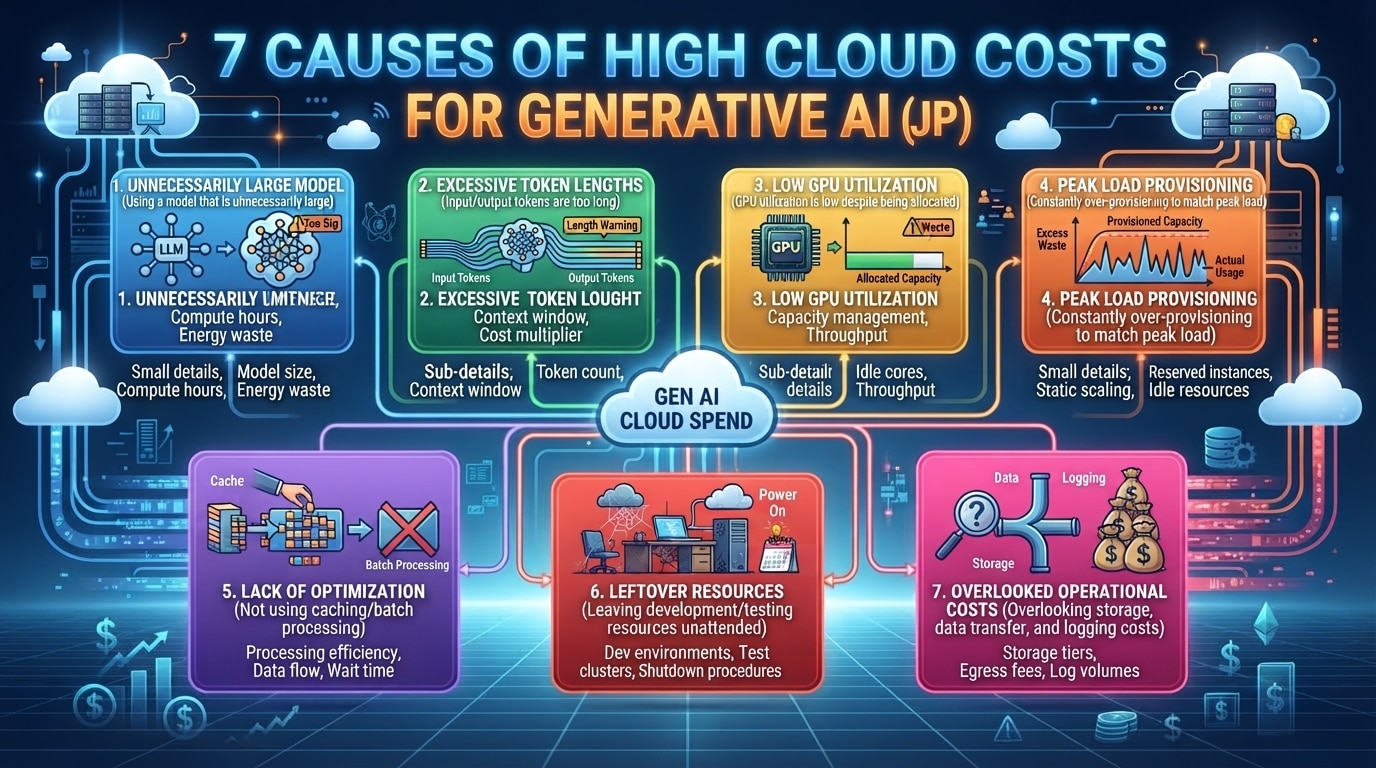
試算を終えて「思ったより高い」となった場合、多くは次の7つのいずれかに当てはまります。
- 必要以上に大きなモデルを使っている
- 入力・出力トークンが長すぎる
- GPUを確保しているのに利用率が低い
- ピーク負荷に合わせて常時オーバープロビジョニングしている
- キャッシュ・バッチ処理を使えていない
- 開発・検証用リソースを放置している
- ストレージ・データ転送・ログ費を見落としている
原因 | 01 |
必要以上に大きなモデルを使っている
単純な分類・要約・抽出のようなタスクにも、最上位クラスの汎用モデルを使ってしまうと、性能に対してコストが見合わなくなります。
まず最小サイズのモデルから精度を評価し、要求品質を満たす最小のモデルまで段階的に引き上げる、というライトサイジングの考え方が基本になります。
原因 | 02 |
入力・出力トークンが長すぎる
不要な会話履歴の全件送信、根拠のない全文投入、過剰なFew-shot例、必要以上に長い出力設定は、いずれもAPI費用とレイテンシを同時に悪化させます。
RAGでは取得する文書数を絞る、会話履歴は要約メモリに置き換えるといった工夫が有効です。
原因 | 03 |
GPUを確保しているのに利用率が低い
専有GPUを確保する構成では、リクエストが来ていないアイドル時間もそのまま課金対象になります。
GPU利用率、待機リクエスト数、TTFT、tokens/secなどの指標を継続的に見て、過剰なGPU台数・過大なインスタンスサイズを見直す必要があります。
原因 | 04 |
ピーク負荷に合わせて常時オーバープロビジョニングしている
「ピーク時に必要な台数」を24時間365日維持してしまうケースです。
オートスケーリング、リクエストのキューイング、非同期処理、使われていない時間帯はリソースをゼロにするscale-to-zeroなど、負荷に応じて構成を伸縮させる選択肢を検討します。
原因 | 05 |
キャッシュ・バッチ処理を使えていない
同じ長いプロンプトを繰り返し送っている、リアルタイム性が不要な処理を同期APIで実行している、といった状態はコストを押し上げます。
主要な生成AI APIでは、同一プレフィックスの再利用に対するキャッシュ割引や、即時応答が不要なリクエストをまとめて処理するバッチ処理向けの大幅な割引メニューが用意されています。用途に応じて使い分けることで、同じ処理でも原価を大きく下げられます。
原因 | 06 |
開発・検証用リソースを放置している
PoC用に立てたGPUインスタンス、検証用のエンドポイント、テスト用のVector DB、負荷試験後のスナップショットやログ環境などが、本番リリース後もそのまま残っているケースは非常に多く見られます。
環境ごとにタグを付け、一定期間アクセスがなければ自動停止する仕組みを前提にしておくことが有効です。
原因 | 07 |
ストレージ・データ転送・ログ費を見落としている
モデルの推論費用だけを見ていると、RAG用のドキュメントストレージ、Vector DB、生成された画像・動画、監視ログ、リージョンをまたぐ通信費などが見えなくなります。これらを含めたTCOで継続的に確認する必要があります。
※この章と次章は対になっています。原因を特定できたら、対応する最適化方法を次章から選んでみてください。
AI開発の基本的な進め方に関しては、こちらの記事を参考にしてみてください。
API型と自前ホスティング、どちらが安いのか
前章までは、API型・自前ホスティングどちらの構成にも共通するコストの数え方と計測方法を扱いました。
ここからは、「このままAPI型を使い続けるべきか、自前ホスティングに切り替えるべきか」という、多くのプロジェクトが最終的に直面する問いを、実際に計算できる形に落とし込みます。
コストの増え方が違う:変動費 vs 固定費
API型と自前ホスティングでは、コストが増える形そのものが異なります。
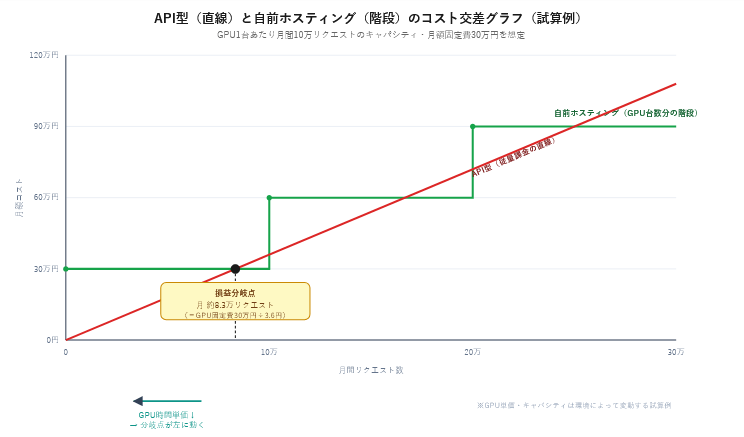
API型はトークン従量課金なので、コストは変動費です。リクエストが増えれば増えるほど、コストもほぼ線形に増えていきます。
自前ホスティングはGPUインスタンスの確保費が中心なので、コストは固定費に近い性質を持ちます。GPUを1台確保すると、その時間帯にリクエストが1件でも100件でも、確保している限り同じ料金がかかります。
1台のGPUが捌けるリクエスト数の上限に達したら、2台目を追加する必要があり、コストは階段状に増えていきます。
GPU 1台が月に何リクエスト捌けるかを実測する
GPU1台あたりのキャパシティを決めるには、前章で紹介したtokens/secやTTFTの実測値を使います。
考え方はシンプルで、GPU1台が同時に処理できるリクエスト数と、1リクエストあたりの平均処理時間が分かれば、1時間・1ヶ月あたりに捌けるリクエスト数の目安を計算することができます。
GPU1台の理論スループット(件/時) = 同時実行数 × (3,600秒 ÷ 1リクエストあたり平均処理時間)ただし、実際の処理能力は、入力・出力トークン数、同時実行数、バッチング、リトライ、タイムアウト、トラフィックの偏りなどによって変わります。
そのため、理論値に一定割合を掛けて決めるのではなく、負荷試験を行い、必要なレイテンシやSLOを満たせる持続スループットを実効値として採用するのが安全です。
この実効値は、負荷試験ツールで実際にリクエストを送り込み、レイテンシが劣化し始める手前の同時実行数を探ることで求めるのが確実です。
損益分岐リクエスト数を計算する
実際に比較する場合は、API型を「月間リクエスト数 × APIの1リクエストあたり原価」、自前ホスティングを「必要GPU台数 × GPU月額費 + ストレージ・ネットワーク・監視・運用などの費用」として比較します。
GPU 1台の処理上限を超えると追加のGPUが必要になるため、リクエスト数の増加に対して自前ホスティングのコストは増えていきます。
損益分岐リクエスト数 = GPU1台の月額固定費 ÷ API型の1リクエストあたり単価ここでは簡易的な試算例として、API型の1リクエストあたりモデル利用料を3.6円、GPU 1台の月額固定費を30万円、GPU 1台で処理できる上限を月10万リクエストと仮定します。この条件では、次のようになります。
損益分岐リクエスト数 = 300,000円 ÷ 3.6円 = 約83,000リクエスト/月この簡易試算では、約8.3万〜10万リクエスト/月の範囲では、GPU 1台分の固定費がAPI利用料を下回る計算になります。
ただし、10万リクエスト/月を超えて追加のGPUが必要になれば、自前ホスティング側のコストも増えるため、再度損益分岐を計算する必要があります。
また、実際の比較では、モデルの回答品質、レイテンシ、可用性、ストレージ・ネットワーク費、運用工数なども含め、同等の要件を満たす構成同士で比較することが重要です。
これをグラフにすると、API型は原点を通る直線、自前ホスティングはGPU台数分だけ段差のある階段として描けます。
AIサーバーのオンプレミスとクラウドサービスの具体的な比較基準は、こちらの記事で詳しく紹介しています。
生成AIのクラウドコストを最適化する8つの方法
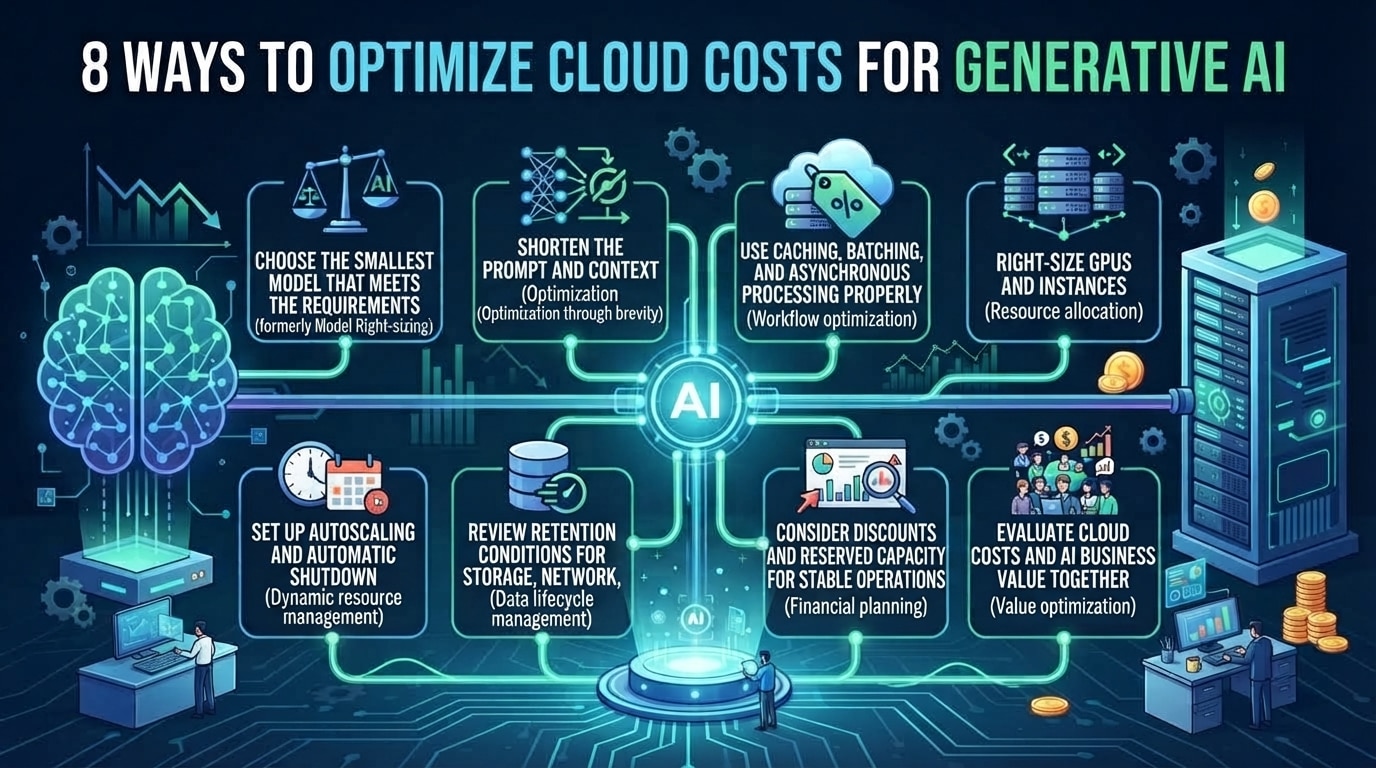
前章の原因に対応する形で、実践的な最適化方法を8つ紹介します。
- 要件を満たす最小モデルから選ぶ
- プロンプトとコンテキストを短くする
- キャッシュ・バッチ・非同期処理を使い分ける
- GPU・インスタンスをライトサイジングする
- オートスケーリングと自動停止を設定する
- ストレージ・ネットワーク・ログの保持条件を見直す
- 安定稼働するリソースは割引・予約枠を検討する
- クラウドコストとAIの事業価値をセットで評価する
- 最適化の方法①
要件を満たす最小モデルから選ぶ
タスクごとに品質評価セット(正解データ)を用意し、小さく安いモデルから順に精度を検証します。
性能が足りない場合のみ上位モデルに切り替える、モデルのライトサイジングを最優先の最適化として位置づけます。
- 最適化の方法②
プロンプトとコンテキストを短くする
RAGのTop-kを絞り込む、長くなった会話履歴を要約してから渡す、出力トークンの上限を用途に応じて設定するなど、不要な入出力を削減します。
トークン量の削減は、コストだけでなくレイテンシの改善にも直結します。
- 最適化の方法③
キャッシュ・バッチ・非同期処理を使い分ける
同じプレフィックスを繰り返し送るワークロードにはプロンプトキャッシュを、即時性が不要な処理にはバッチ処理や非同期処理を割り当てます。ユーザーが画面を見て待っている処理と、バックグラウンドで完結してよい処理を分離することで、体験を落とさずにコストを下げられます。
以下はAnthropic Claude APIを例にした実装差分です。
実装差分:プロンプトキャッシュを追加する
同じシステムプロンプトやRAGコンテキストを繰り返し送るリクエストでは、再利用したい部分をPrompt Cachingの対象にできます。
初回はキャッシュへの書き込み料金が発生しますが、キャッシュの有効期間内に同じprefixを再利用できれば、キャッシュヒットした部分を通常の入力より低い単価で処理できます。
料金やTTLなどの条件は変更される可能性があるため、実装時にはAnthropicの最新の公式ドキュメントを確認してください。
response = client.messages.create(
model="<使用するモデル名>",
max_tokens=1024,
system=[
- {"type": "text", "text": long_system_prompt}
+ {"type": "text", "text": long_system_prompt, "cache_control": {"type": "ephemeral"}}
],
messages=[{"role": "user", "content": user_question}],
)
キャッシュの有効期間内に同じprefixを再利用すると、キャッシュヒットした部分に割引された入力単価が適用されます。
キャッシュ対象となるprefix内の内容が変わるとキャッシュミスになるため、システムプロンプトや固定のRAGコンテキストなど変化しにくい部分をキャッシュ対象にし、ユーザー入力のようにリクエストごとに変わる部分はその後ろに配置するのがポイントです。
実装差分:同期呼び出しをBatch APIに置き換える
即時応答が不要な処理は、リクエストごとに応答を待つ同期呼び出しから、まとめて投げて後で結果を回収するBatch APIに置き換えると、同じ処理でも料金が下がります。
- results = []
- for prompt in prompts:
- response = client.messages.create(
- model="<使用するモデル名>",
- max_tokens=1024,
- messages=[{"role": "user", "content": prompt}],
- )
- results.append(response.content[0].text)
+ batch = client.messages.batches.create(
+ requests=[
+ {
+ "custom_id": f"job-{i}",
+ "params": {
+ "model": "<使用するモデル名>",
+ "max_tokens": 1024,
+ "messages": [{"role": "user", "content": prompt}],
+ },
+ }
+ for i, prompt in enumerate(prompts)
+ ]
+ )
+ # ジョブ完了後(最大で数時間〜24時間程度)に batch.id で結果一覧を取得する
同期版はリクエスト数分だけ待ち時間が直列に積み上がりますが、Batch版はジョブを一括投入して後から結果を回収する構成に変わります。
レスポンスをその場で使わない処理ほど、この置き換えによるコスト・実装両面のメリットが大きくなります。
- 最適化の方法④
GPU・インスタンスをライトサイジングする
モデルの重みがVRAMに載るかどうかだけでなく、必要な同時実行数・スループット・SLOを満たす最小構成を実測して選定します。
高性能なGPUほどコスト効率が良いとは限らず、ワークロードによっては複数の小型GPUに分散した方が費用対効果が高いケースもあります。
- 最適化の方法⑤
オートスケーリングと自動停止を設定する
待機リクエスト数や推論負荷に応じてインスタンスを増減させ、夜間や検証環境は停止します。
リアルタイム性が不要な非同期ワークロードでは、scale-to-zero構成も検討対象になります。
- 最適化の方法⑥
ストレージ・ネットワーク・ログの保持条件を見直す
ログの保持期間、不要になったデータのライフサイクル管理、リージョン配置の見直しなど、モデル本体以外のコストも定期的にレビューします。生成AI以外の部分で積み上がるコストは見落とされがちなので、レビューを習慣化することが重要です。
- 最適化の方法⑦
安定稼働するリソースは割引・予約枠を検討する
利用量がある程度予測できるようになった段階で、予約インスタンスやコミットメント割引の活用を検討します。
逆に、需要がまだ読めないPoC段階で長期契約を結んでしまうと、後から構成を変えづらくなるため避けます。
- 最適化の方法⑧
クラウドコストとAIの事業価値をセットで評価する
「月100万円削減できた」という数字だけで評価するのではなく、AI機能によって生まれた売上・CVR改善・工数削減・継続率向上などと比較して評価します。
コストを下げるために回答品質やレイテンシを悪化させてしまわないように、コストと品質・体験のバランスを常にセットで監視するようにしましょう。
AI開発にかかるリアルな費用相場や抑える方法は、こちらの記事で紹介しています。
コスト構造を把握したら、GPU基盤の選び方を見直そう

生成AI機能をプロダクトに組み込む際のクラウドコストは、従来の「月間ユーザー数×サーバー費」という発想では見積もれません。トークン量・GPU時間・生成回数といった単位に分解し、PoC段階の数字をそのまま本番予算にしないことが出発点になります。
試算を進めていくと、多くのプロジェクトが最後に行き着くのが「GPU基盤をどこで、どう確保するか」という問題です。大手クラウドのGPUインスタンスは高性能な一方、常時確保するとアイドルコストが積み上がりやすく、ライトサイジングや自動停止の運用にも継続的な工数がかかります。
GPU部分だけを切り出して他の選択肢と比較してみると、試算した原価上限に収まる構成が見つかるがあります。
NVIDIA H200を搭載したGPUが、業界最安値で使える!
GPUSOROBANは、NVIDIAの高性能GPUを業界最安級の料金で利用できるGPUクラウドサービスです。環境構築の手間を抑えながら、必要な時に必要な分だけGPUを確保できます。料金プランや構成例をまとめた資料を無料でご用意していますので、本記事で試算したコストと比較する材料として、まずは資料請求からご検討ください。